 Techroomage
電壓乘上十五倍、電流剩不到百分之七:AI 機房把配電拉上 800V 直流
一百萬瓦用 54V 傳輸需近一萬九千安培,改走 800V 直流只剩約一千二百五十安培,本文從電流、銅排與機架空間的物理帳,分析 NVIDIA 的高壓直流電力路徑、54V 架構碰到的四個瓶頸,以及電源供應鏈座標的位移。
兆瓦級 GPU 機架讓 54V 供電先在銅排、空間與保護設計上見底;NVIDIA 的 800V 直流架構把整流與保護移出計算機架,電源從伺服器的零件變成機房的設施。
先算一筆電流的帳
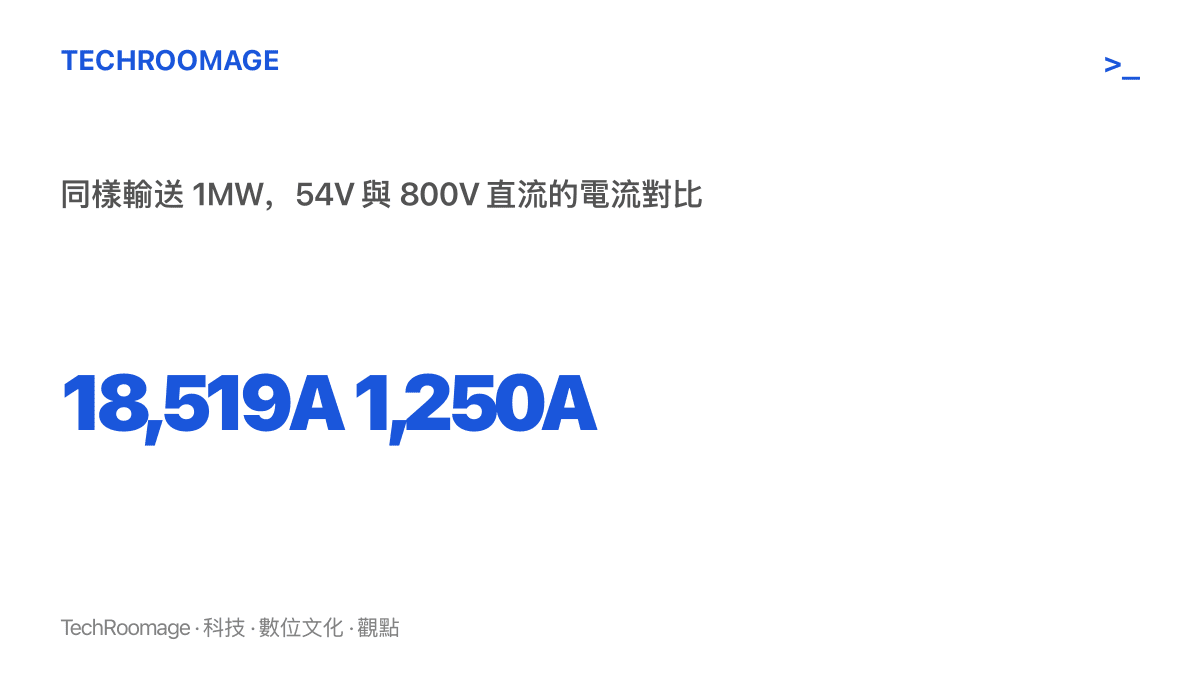
把一百萬瓦送進一個機架,走 54V 的配電,導線裡流的是約 18,519 安培;同樣的功率改用 800V 直流輸送,只剩約 1,250 安培。這是功率除以電壓的直接結果,屬於理想化比較,沒有計入功率因數、轉換效率、線路距離與並聯導體,但方向夠清楚:電壓拉高,電流等比例縮小,而電流正是機房配電裡最貴的變數。
貴在兩個地方。一是導線發熱,電阻損耗用 I²R 計算,電流加倍,理想化損耗會變四倍,這些損耗全部變成熱,再由風冷或液冷花容量帶走。二是導體本身,電流越大,銅排截面越粗、並聯導體越多、接點越大,導體佔掉的空間直接壓縮伺服器、交換器與維修通道。等於同一份功率,先在銅上浪費一次,再在冷卻上浪費第二次。
這筆帳在 AI 時代變成迫在眉睫的工程題目。GPU 機櫃功率密度已經站上數百千瓦,NVIDIA 的 Kyber 機架以兆瓦級為目標,該公司技術文件也明言,54V 架構在機架超過 200kW 時就開始碰到空間與材料限制。AI 對硬體的壓力已經長出機房,連桌機都被推著走,先前M5 Ultra Mac Studio 的首批評測就把 256GB 統一記憶體指往本地 AI 工作流。需求在漲,舊配電的餘裕在縮,800V 直流就是在這個交叉點上被推上檯面。
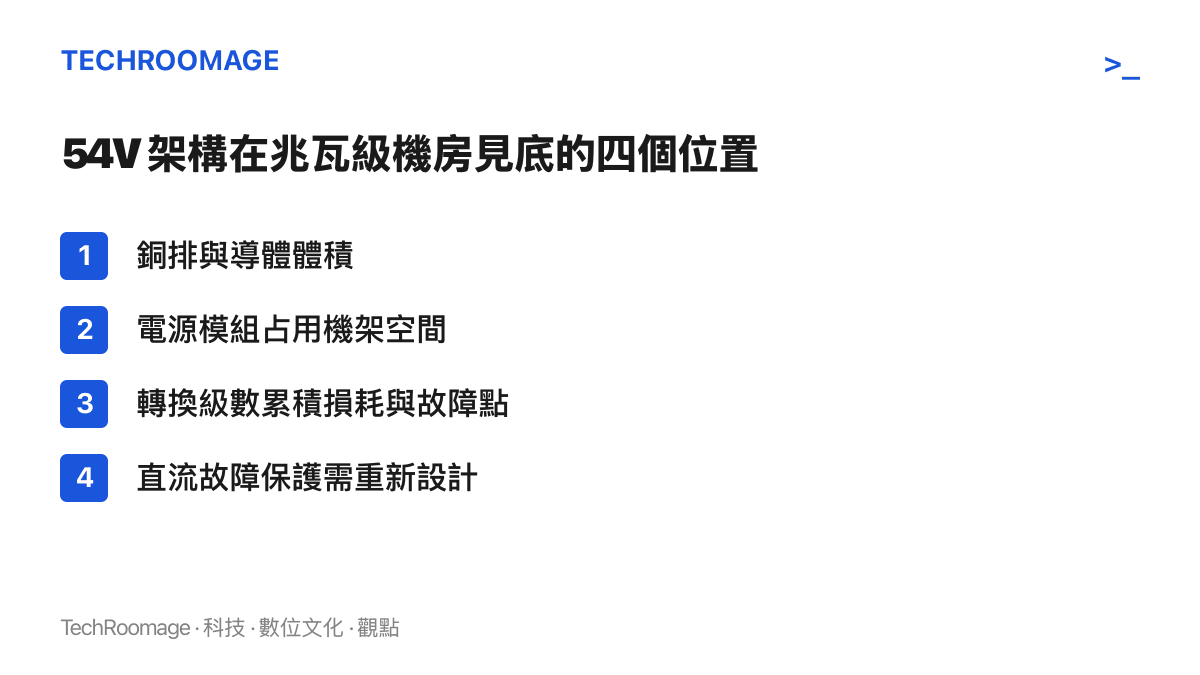
54V 的餘裕,在四個地方見底
第一個見底的地方是銅。NVIDIA 以單一 1MW 機架估算,若沿用 54V 配電,銅排最多可能用掉 200 公斤的銅,實際數字仍取決於路徑與設計條件。這個量級說明的是趨勢:低壓高電流系統的導體體積隨功率往上膨脹,機架裡每多一公斤銅,就少一份放算力的空間。
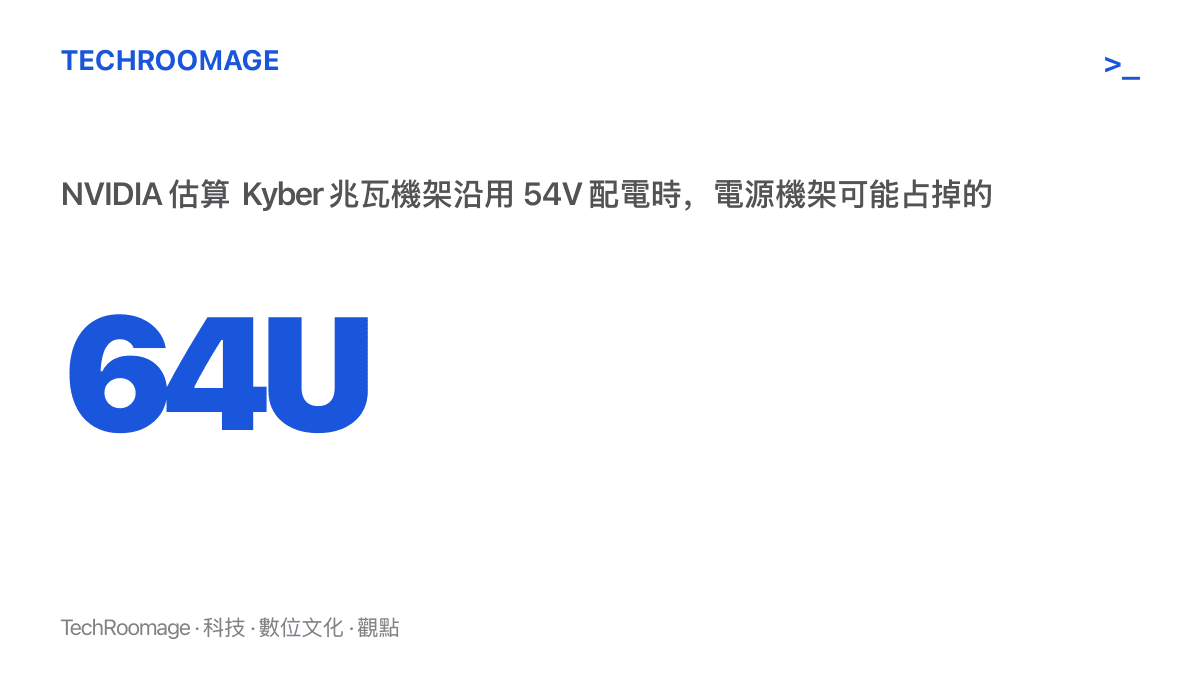
第二個是空間。AI 伺服器功率上升時,電源供應器不能只把瓦數標高,還要處理輸入電流、瞬態負載、散熱、備援與可維修性,這些都以 U 數計價。NVIDIA 以 Kyber 兆瓦機架估算,沿用 54V 配電時電源機架可能佔到 64U,留給 GPU 與交換器的空間同步被擠壓。
第三個是轉換級數。傳統路徑從交流電網進變壓器、不斷電系統(UPS)與配電設備,到機架內的 AC/DC 電源供應器,再降到 54V、12V 或板級電壓。每一級轉換都產生損耗與熱,也多出控制電路、風扇、模組與維修節點,級數越多,故障點的清單越長。
第四個是保護。交流電每個週期有過零點,直流沒有,斷開故障電流時的電弧、電容放電、預充與負載隔離都要明確處理。NVIDIA 的架構說明把選項列為熔斷器加隔離開關、固態裝置或安全斷路器,並把過電流保護放在電力室到資料廳、資料廳到列級、列級到 IT 機架三段邊界。保護邏輯的改寫,是整個架構遷移裡最不能出錯的一段。
800V 進機房,54V 進主機板
800V 不會直接送上 GPU。NVIDIA 公開的架構是:在機房邊界把中壓交流電集中轉成 800V 直流,經資料廳與列級母線送到 IT 機架,機架內再由 DC/DC 轉成 54V、12V 與供應 GPU 的核心電壓。這條路徑仍然多級轉換,差別在於最佔空間的 AC/DC 電源模組離開了計算機架,直流配電移到更適合做分段保護與維修的位置。NVIDIA 的架構頁面把方向描述為從多次交流轉換,逐步走向單次 AC 到 800VDC 的配電路徑,資料廳到機架之間的重複轉換被收斂掉,轉換、保護與備援集中在機房側處理。
這也催生了 power rack 與 sidecar 的設計:電源設備從 IT 機架分出去,計算設備、配線與液冷管路各有清楚的空間邊界,檢修電源不必碰計算側,擴充算力不必重排電源。把相依的東西搬出去集中管理,換日常的穩定,這個思路在軟體端也有對照,先前DeepSeek 開發者在 harness 與直連客戶端之間的選擇題,量的正是依賴面積:相依越少、越集中,日常越穩。
電源從伺服器零件,變成機房設施
架構一改,供應鏈座標跟著移。過去伺服器電源供應器的競爭項目是瓦數密度、轉換效率與安規,產品形態是裝在機殼裡的模組;當整流搬到機房邊界、以 800V 直流母線配送,競爭場地換成電力室與列級配電,產品變成機櫃級與房間級的電源設備。對長期經營電源供應器與被動元件的臺灣供應鏈來說,這是產品定義整個搬家的局面。
規格門檻同步抬高。熔斷器、隔離開關與固態裝置要在更高的直流電壓下,可靠斷開沒有過零點的故障電流;連接器、母線與監控元件要處理 800V 等級的絕緣與安全距離;電容、電感等被動元件的耐壓與壽命要求一起上調。這些品項過去在伺服器物料清單裡多半是配角,現在成了架構能否成立的關鍵料。
機會與風險來自同一個變動。機會在於電源與保護的價值從單機移到機架與機房層級,原本做板卡級、機殼級元件的廠商,有機會往更高電壓、更高單價的品項走;風險在於新場地的規格由雲端業主與 GPU 平臺主導,設計主導權比過去更集中。誰能提早進入 800V 直流的參考設計,誰就拿到下一代機櫃的入場券。
接下來可盯的訊號
先看機架世代與 800V 的綁定節奏。Kyber 之後的兆瓦級機架若把 800V 直流輸入列為預設選項,供應鏈的改版壓力就從示範案變成量產案,屆時電源與保護元件的規格書會先給出答案。
再看保護方案誰出線。熔斷器加隔離開關、固態裝置與安全斷路器各有成本、壽命與反應速度的取捨,量產選擇會直接決定保護元件的訂單流向,這也是觀察固態開關成熟度最實際的指標。
第三看既有機房怎麼辦。800V 架構需要新的電力室、母線與機架配置,對新建園區是設計題,對既有機房接近重建題,兩者的比例會決定這波遷移是幾年內的主旋律,還是拉長到十年的替換週期。
第四看標準與生態。雲端業者自建規格、產業聯盟制定共通標準的動作,會決定 800V 直流是單一 GPU 平臺的專屬路線,還是全行業的公共建設。後者成真時,受益名單會遠不只一家供應鏈。
下一次模型變快變便宜,功勞簿上除了演算法,還該記上某個把配電改成 800V 直流的機房:省下來的銅、空間與熱,最後都換成了算力,而算力的單位成本,正是被這類很硬的工程決策一路壓下來的。
資料來源:本站編輯參考 APPI News〈AI 機房為什麼改走 800V 直流供電?舊架構撐不住的地方在哪〉(作者:張饒輝 Lightman Chang)改寫而成,原文出處;原文文字內容採 CC BY 4.0 授權。