 Techroomage
事實答對,出處引錯:MCP 代理的來源驗證,要逐份文件對帳
退款期限是真的,出處卻可能記到別份文件上;這篇用客服的例子說明逐源比對的驗證流程、醫療資料上的測試數字,以及誤攔之後仍需要人工覆核的原因。
答案裡每個字都查得到根據,引用卻可能指向別份文件。逐源比對的驗證方法補上這一關,但誤攔的主張,最後仍要人來覆核。
客服代理的一句話,對了一半
「依帳戶紀錄,這個方案提供 30 天退款期。」
客服代理說完這句話,使用者在介面上看到引用來源,放心送出退款申請。這句話的內容是對的:30 天退款期確實存在,寫在退款政策文件裡。錯的是開頭那四個字。帳戶紀錄裡並沒有這項資訊,答案卻把依據記在它頭上。事實正確、出處引錯,答案看起來完美,依據卻記錯了帳。
這是 Hugging Face 於九月底刊出的一份研究要處理的問題。研究提出的方法叫 ProvenanceGuard,對象是 MCP 代理:一種透過 MCP(Model Context Protocol,模型上下文協定)連接外部工具的 AI 助理。這種代理接到問題後,會自己決定查資料庫、呼叫搜尋工具或翻文件庫,再把多份輸出整理成一段答案。
用一句話講完這份研究:代理可能答對事實、引錯來源,ProvenanceGuard 保留每份工具輸出的來源身分,把答案切成一項項可查核的主張,逐源比對主張與來源的對應關係。
忠實度評分為什麼抓不到這種錯
檢查「答案有沒有根據」並非新鮮事。RAG(檢索增強生成)的應用裡,「忠實度」評分用來檢查答案是否受到檢索內容支持,無中生有的段落多半抓得出來。
問題出在檢查的顆粒度。常見做法把所有來源合併成一份脈絡,只問一句:這句話有沒有地方支持?回到退款例子,30 天的文字確實在合併內容裡找得到,檢查通過。至於答案說的「帳戶紀錄」是不是真正支持這句話的文件,合併脈絡看不出來。
這個缺口對兩種人的代價不同。使用者拿引用來源判斷答案可不可信,引錯文件等於拿錯依據做決定:在退款資格的爭議裡,政策文件和帳戶紀錄的效力不一樣。負責營運代理的團隊則在事後追溯時付帳:答案出了問題,得逐份翻文件才能重建當初依據哪一份,稽核成本輕易喫掉代理省下的工時。
要求每個說法接得上具體證據,這個方向在其他 AI 領域也出現過。我們先前整理過OpenAI 要求每個安全主張附上證據與負責人的訓練指引,兩者的道理相通:說法要能對到證據,決策才有依據。
逐源對帳:借會計的辦法
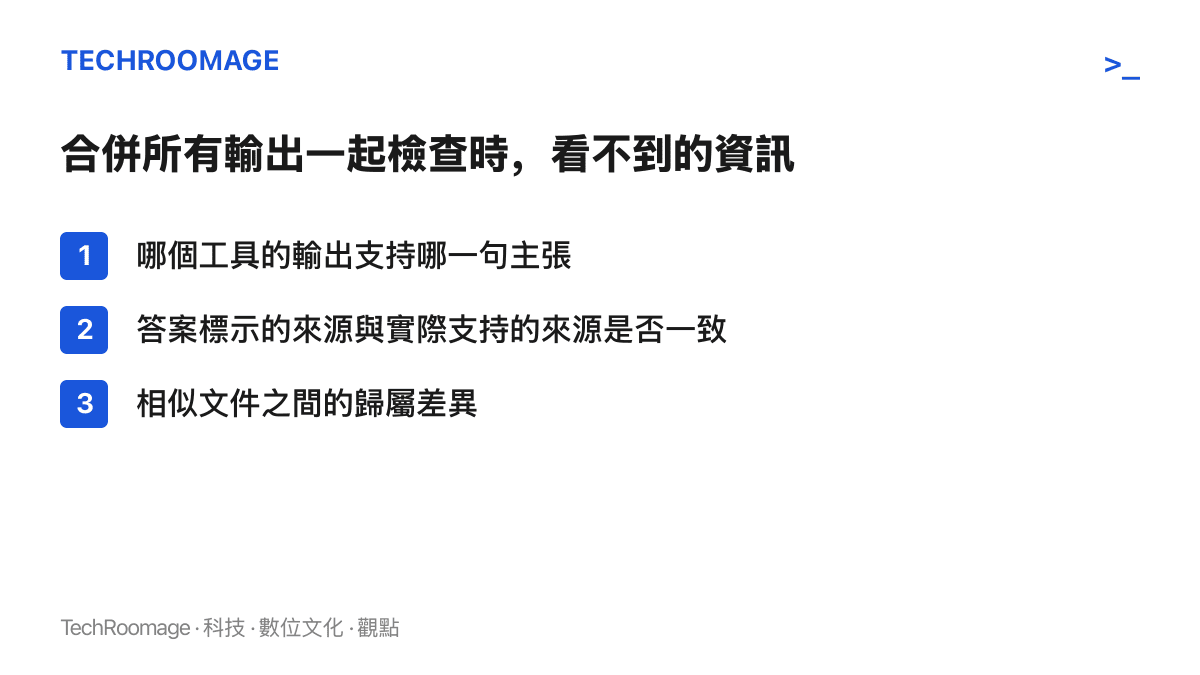
想像一位會計在看報帳單。他不會把所有發票疊成一疊,看總金額對得上就放行;每一筆支出都要對到那一張發票。ProvenanceGuard 對答案做的事接近這樣:每一句話都要對到那一份文件。
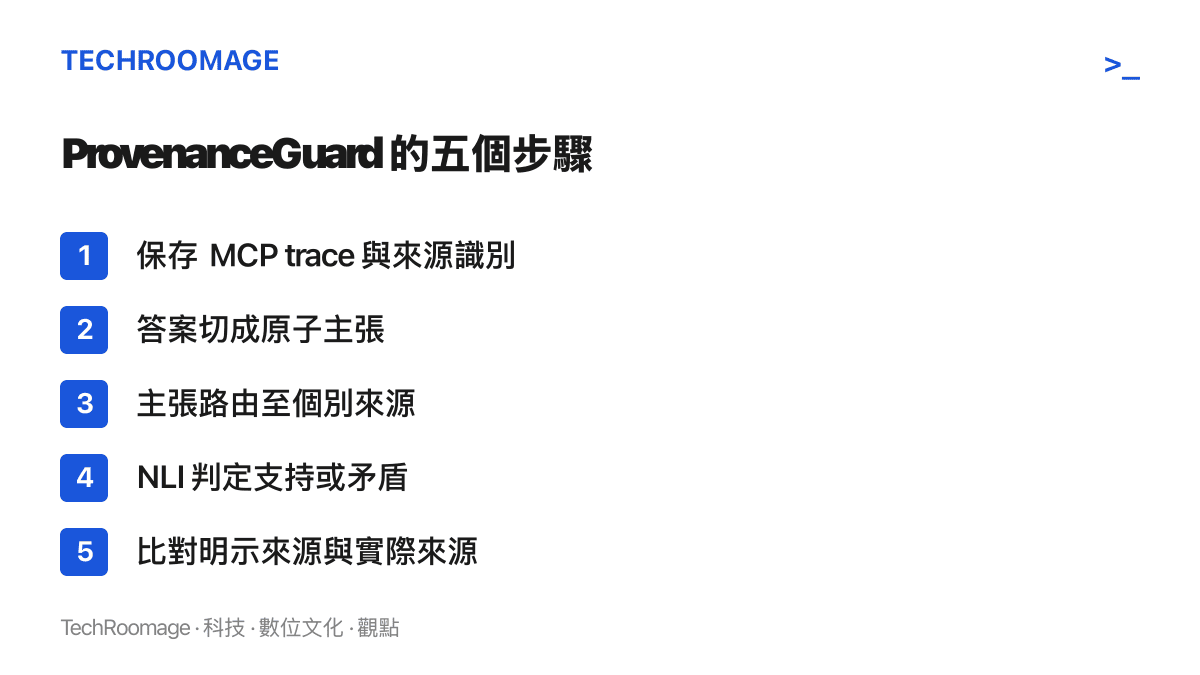
流程從儲存 MCP trace 開始。trace 是代理呼叫工具的完整記錄,每筆證據帶著工具類型、來源識別碼與輸出內容,同一個工具查詢不同文件也要能區分。這一步是地基。來源沒有穩定識別碼時,研究的方法只能退回用工具名稱當標記,判斷精細度隨之下降;trace 儲存不全,驗證器連答案的資料從哪裡來都重建不了。
接著把答案切成原子主張:一句只保留一個可檢查的事實,句子裡提到的來源、數字、日期與單位一併留下。「帳戶紀錄顯示可在 30 天內退款」會切成「退款期限為 30 天」這項主張,加上「帳戶紀錄」這個歸屬標籤。
然後是路由與判定。系統為每項主張找出最相關的來源專屬內容,交給自然語言推論(NLI)模型判斷:這份資料支持主張、與主張矛盾,還是無法判定。NLI 模型做的事,接近人讀文件時問的那句「從這段文字,推得出那個結論嗎」。系統還會檢查文字對齊,確認關鍵數值真的出現在指定來源裡。
最後一步是歸屬比對。答案明說或暗示的來源,要與實際支持主張的來源對得上。政策文件支持 30 天退款期,帳戶紀錄沒有這項資訊,歸因不一致就會被標記。驗證結果可逐項呈現,也能彙整成答案層級的允許或阻擋;被擋下的答案可送入類似 RARR 的修復流程,改寫成有來源支持的說法,或退回保守文字,重新驗證一次。
測試數字能讀到什麼
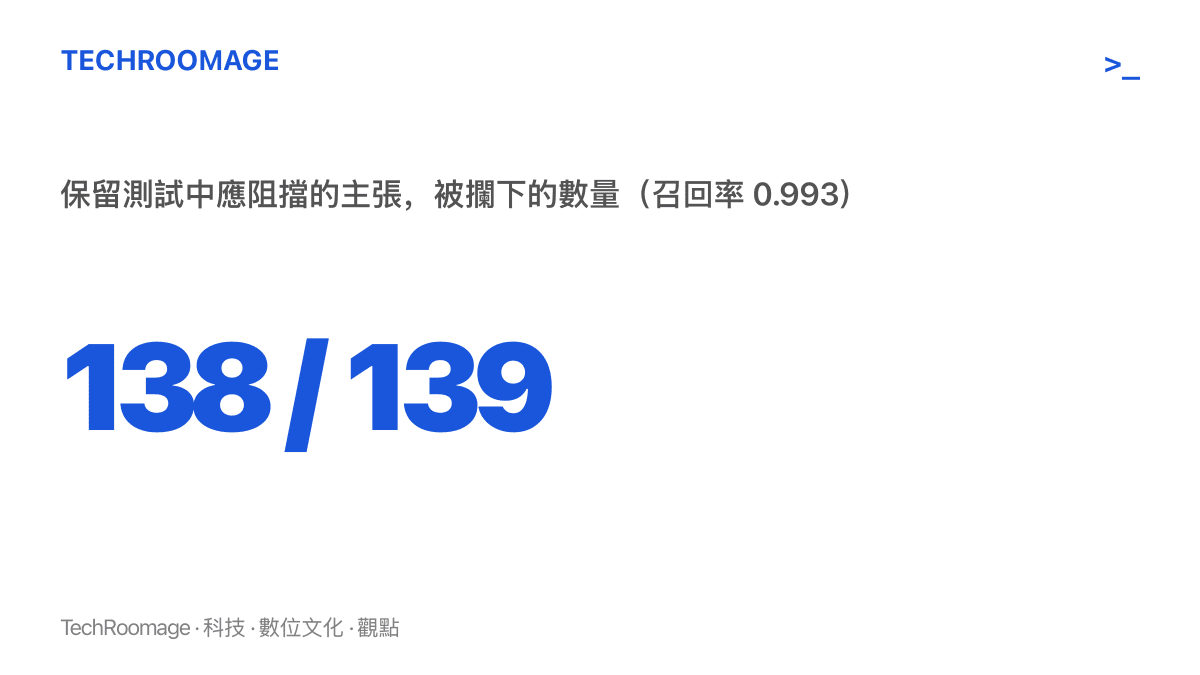
這篇 arXiv 預印本以 281 筆醫療領域的 MCP trace 作為測試場景,其中 266 筆建立了主張標註。保留測試集有 361 項主張,139 項應該阻擋、222 項有來源支持;這個測試集經人工專家覆核,訓練與驗證集的標註由模型協助產生,論文並未宣稱有同樣的覆核強度。
阻擋表現的 F1 為 0.802,分開看更誠實:精確率 0.673、召回率 0.993。應阻擋的 139 項裡,138 項被攔下,只放行 1 項;但有來源支持的 222 項裡,67 項被誤攔。論文描述誤攔後送交覆核或修復,這是工作流程的處置方式。換句話說,誤攔的最後一關,還是人。
另外以 260 項具來源標註的主張計算,來源歸屬準確率為 0.858。研究自己也點出限制:相似來源之間的精確辨認仍有明顯落差。而且這些數字出自特定測試設定,醫療領域、模型輔助標註;換一個產業、換一組工具,成績不會自動沿用。
還要劃出一條界線:這是事後檢查層。它查的是答案有沒有引對來源,不會替來源本身的正確性背書,也不會自動證明未列出的事實都沒問題。
部署的人與看答案的人,各拿走一件
對開發與營運代理的團隊,這份研究給的順序很清楚。trace 要從第一天就儲存,來源要有穩定識別碼,別等到要驗證才回頭補記原始輸出。驗證流程要預留人工覆核的隊列與人力,高召回率的代價就是誤攔量:67 這個比例乘上每天的答案量,就是需要人看的規模。機器執行、人員驗收的分工,與OpenAI 與新思讓工程師審核代理結果的晶片設計合作是同一個方向,差別在於這裡驗收的是引用,那裡驗收的是電路。
對一般使用者,可以帶走一個習慣:看到答案附了引用,多問一句「這個出處真的寫了這件事嗎」。引用存在與引用正確是兩回事,中間那段距離,正是這份研究花力氣在量的東西。
後續值得盯的訊號有幾個。來源識別碼會不會成為 MCP 生態的標準配備;這類驗證器會被收進代理框架本身,還是以獨立服務的形式出現;誤攔的覆核成本,最後由平臺吸收還是轉給導入的團隊。在那之前,代理附上的引用,先別急著當成查核完畢的證明。
資料來源:本站編輯參考 APPI News〈MCP 代理如何確認答案引用正確來源?來源驗證仍需人工把關〉(作者:張饒輝 Lightman Chang)改寫而成,原文出處;原文文字內容採 CC BY 4.0 授權。