 Techroomage
COBOL 遷移準確率 97.9%:OpenAI 把 AI 帶到企業最不敢動的程式面前
OpenAI 以兩項新評測展示 GPT-6 系列模型在 COBOL 等低資源程式語言的能力躍進,本文整理數字口徑、老系統維修帳的脈絡、成本與驗收之間的取捨,以及後續可依序核對的訊號。
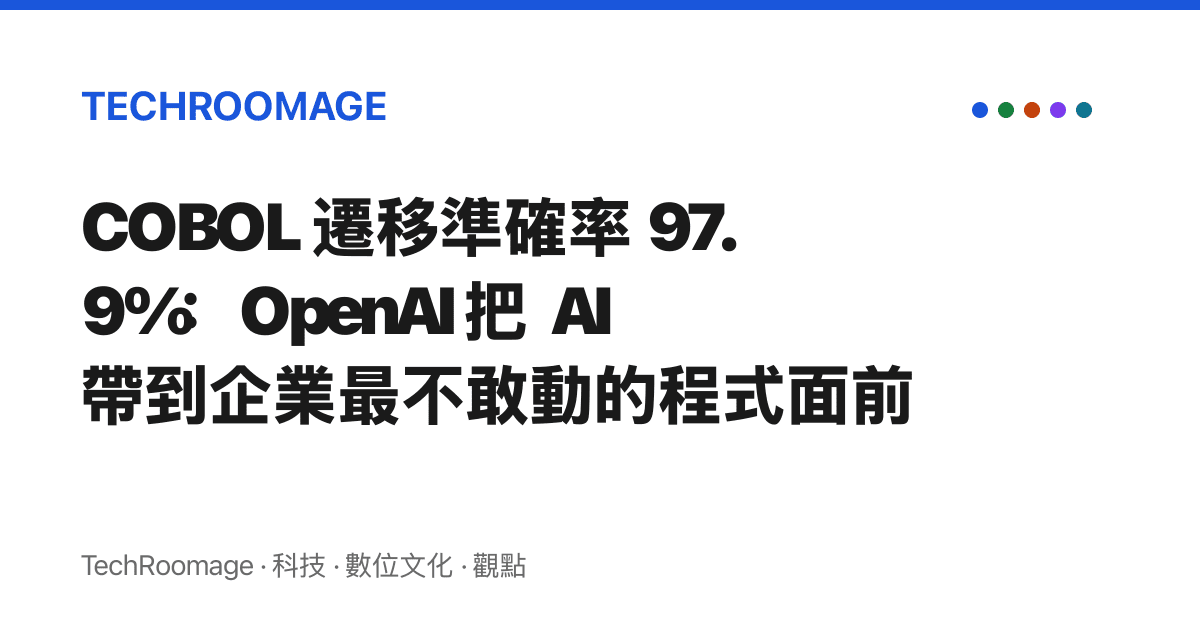
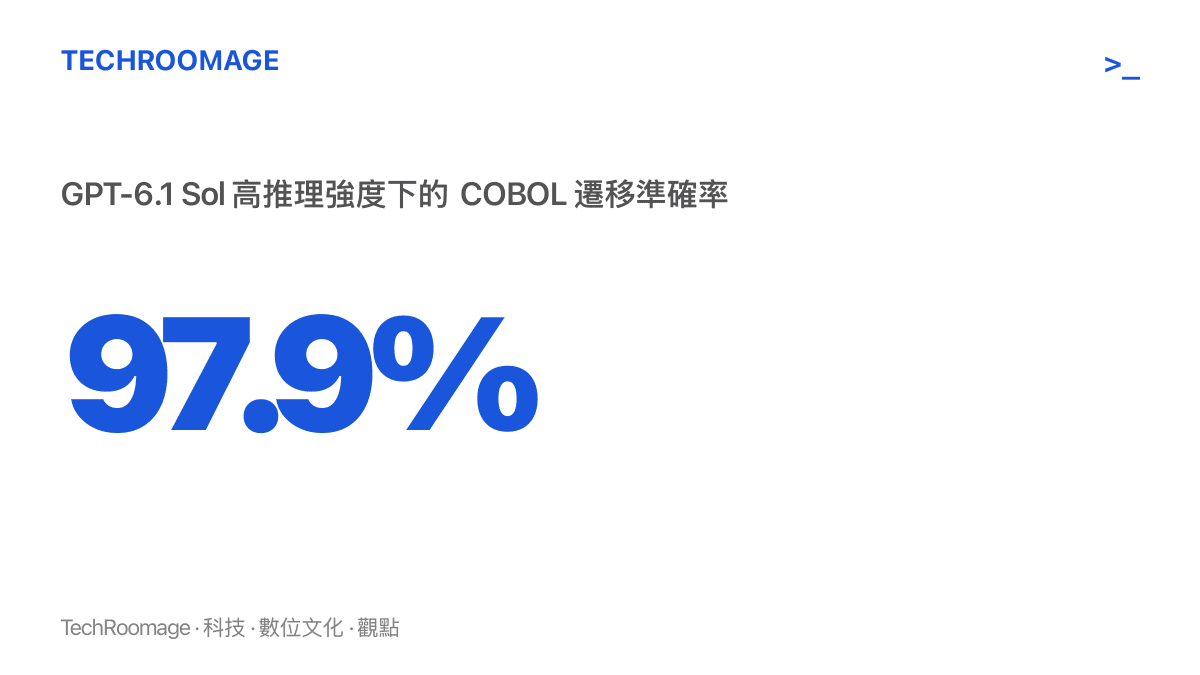
從上一代的 5.4% 到 97.9%,GPT-6.1 Sol 在高推理強度下逼近評測上限;OpenAI 同步強調生產環境仍需專家審查,這句但書決定數字能兌換成多少生意。
同一份 COBOL 遷移評測,GPT-5.6 Sol 的準確率是 5.4%,幾乎等於把題目交給運氣;換上 GPT-6.1 Sol 並調高推理強度,數字跳到 97.9%,接近評測上限。10 月 20 日,OpenAI 發布研究報告,宣稱強化後的 GPT-6 系列模型已能建構與遷移 COBOL、Fortran、Visual Basic 這類「低資源程式語言」:它們在公開網路上的程式碼與文件稀少,卻支撐著銀行、ATM、天氣預報與核能安全分析等關鍵系統。
對一般開發者,這則消息像又一次例行的模型升級;對每年編列大筆預算供養老系統的銀行、保險與政府機構,這是一張可能重寫報價單的成績單。數字與 OpenAI 自己附上的但書之間,才是這件事真正的模樣。
「低資源」:網路上幾乎學不到的語言
「低資源語言」原本是自然語言處理領域的用語,用來形容教材稀少的人類語言;OpenAI 把它借來形容程式語言,意思相通:模型在訓練時幾乎沒看過足夠的範例。
COBOL 誕生於 1959 年,Fortran 更早,兩者都比網際網路老上幾十歲。它們最重要的一批程式,幾十年來躺在銀行與政府機構的大型主機裡,受層層權限保護,從未被放上原始碼託管平臺,技術討論區的熱門話題也輪不到它們。以公開網路資料訓練的模型面對這些語言,處境類似一個只讀過三本課本的學生去考精通級檢定:文法大致記得,實戰細節全靠猜。
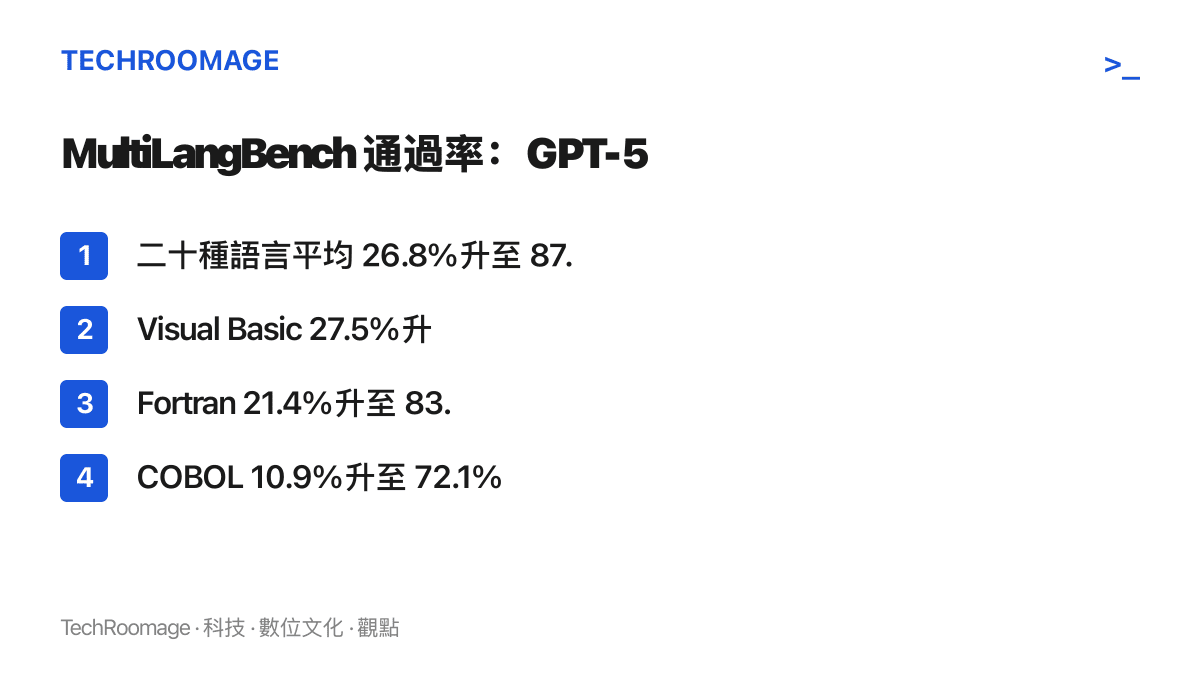
這正是上一代模型成績難看的原因。GPT-5.6 Sol 在 MultiLangBench 二十種語言的平均測試通過率只有 26.8%,COBOL 單項 10.9%。模型並非不會寫程式;問題在於,在這些沒見過足夠範例的語言上,寫出來的東西過不了測試。
兩項評測,分別考「從零建構」與「原樣搬家」
為了量化這件事,OpenAI 設計了兩項評測,各自對應企業的一種需求。
第一項 MultiLangBench 考從零建構:要求模型用二十種語言,各自寫出一個與 SQLite 相容的資料庫引擎,以測試通過率計分。這考的是完整工程能力,模型要掌握該語言的語法與慣例,把一個有模有樣的系統拼出來,而不只是補完幾行函式。
第二項專考搬家:給定 COBOL 程式,要求模型在保持原有業務行為不變的前提下,遷移到 C++、Java、Python 或 Rust。這一項更貼近企業的真實痛點,也更深:遷移的難度向來超過把程式碼換一種寫法,連行為都得一模一樣。COBOL 的十進位定點運算、檔案與交易處理方式,換到其他語言時都有精度與語意對映的問題。過去幾十年,這正是各種自動遷移工具始終停在輔助階段的主因。
成績單:能力、成本與檔次
GPT-6 Astra 在 MultiLangBench 交出的平均成績是 87.4%,較 GPT-5.6 Sol 的 26.8% 大幅推進。個別語言裡,Visual Basic 從 27.5% 升到 89.4%,Fortran 從 21.4% 升到 83.5%,COBOL 從 10.9% 升到 72.1%。就算是最弱的 COBOL,也從接近隨機的層級,進到實務上可以拿出來討論的區間。
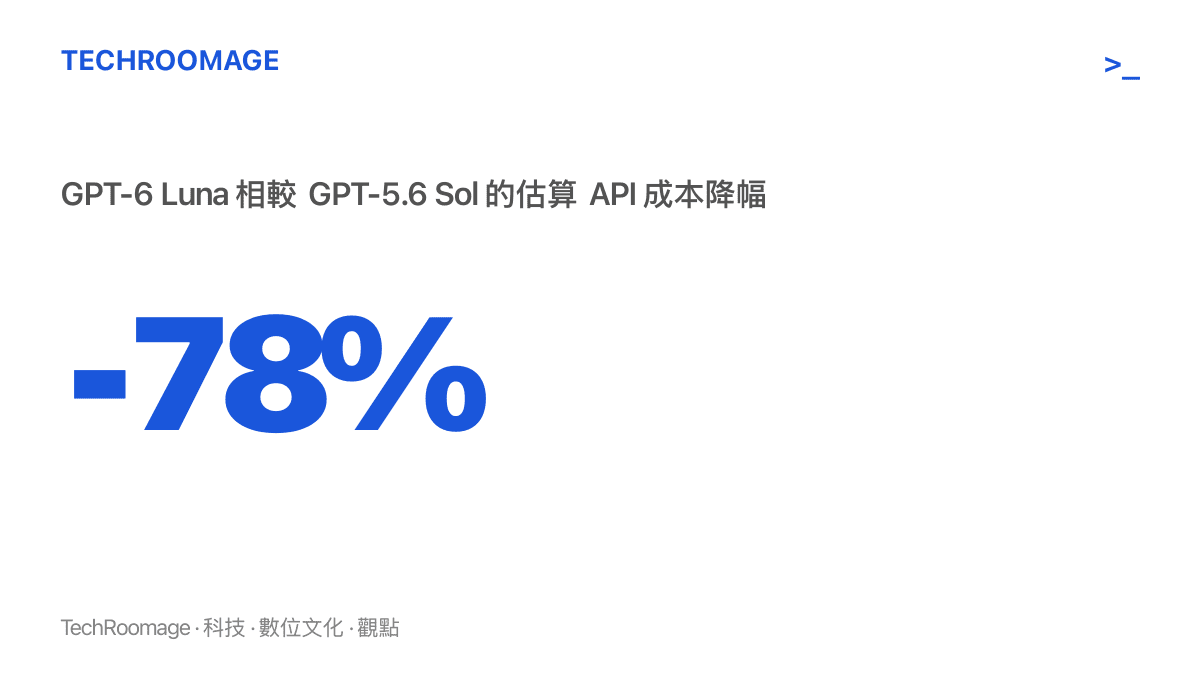
成本是第二個看點。較低價的 GPT-6 Luna 平均通過率 40.3%,估算 API 成本比 GPT-5.6 Sol 低約 78%。用便宜一個量級的價格,就能買到比上一代旗艦更好的平均表現;對需要跑大量程式碼的遷移場景,這是計價方式的直接改變。
第三個看點落在遷移評測本身。GPT-6.1 Sol 在低推理強度下準確率 86.6%,比 GPT-5.6 Sol 的 5.4% 高出一個量級,成本還降低 39%;把推理強度拉高,準確率達到 97.9%,接近評測上限。對企業來說,這代表準確率與花費之間出現了可調的階梯:大量例行轉換交給低強度,關鍵模組用高強度驗算。
這門生意的由來:COBOL 的維修帳
OpenAI 為什麼要費心考一門多數工程師沒寫過的語言?因為老系統的維修帳,是大型機構最硬的一筆支出。
COBOL 系統往往運轉數十年,業務規則層層沉積在程式裡;當年寫程式的人陸續退休,文件散佚,年輕工程師也不願把一門逐漸失去市場的語言寫進履歷。機構手上的選項長年只有兩個:出高價請少數還懂的人繼續修,或者發動大規模遷移專案,把系統重寫進現代語言與架構。後者的風險人盡皆知:行為等價性難以驗證,時程與預算經常失控。
大型主機陣營近年已陸續推出 COBOL 轉 Java 的生成式輔助工具,把遷移視為企業 AI 的下一個戰場。OpenAI 這份報告進的是同一個市場,報告明言,這項進展有助於企業維護老舊系統、修復缺陷並推進軟體現代化。模型能力的競賽,正從主流語言的程式補全,延伸到最冷門、也最值錢的那批程式碼。
但書比數字重要
報告裡最值得抄下來的一句,是提醒:將 AI 遷移結果用於生產環境,仍需專家審查,並結合具體業務規則與依賴關係進行測試。
評測題目是封閉世界,行為可以被完整比對;真實系統動輒百萬行,纏著資料格式、硬體相依,以及沒寫進文件的行為。AI 的輸出再準,最後一哩都在人這邊:誰來證明新程式與舊程式在每一種情境下行為一致?這句但書實際上指出了瓶頸的位置移動。過去卡在沒有人翻得動,未來卡在驗收的能量:等價測試、業務規則梳理與審查人力,會變成遷移專案新的成本中心。
對技術決策者,這與我們先前整理過的模型升級前的五項檢查是同一套紀律:任何帳面成績,都要先換算成自家系統上的實測數字,再談導入。
帳單記在誰頭上
遷移若真的變便宜,受力最直接的是靠人力搬遷舊程式的系統整合與顧問生意,計價基礎會被改寫。還在維護 COBOL 的資深工程師,角色會從翻譯者移向審查者,稀缺性未必下降,工作內容則明顯不同。
費用歸屬也是繞不開的現實問題。API 成本降 78% 聽起來便宜,但遷移專案的大頭向來在驗證與測試,模型費用的降幅要放進整本帳衡量。這與我們先前分析過的管 AI 用量之前,先回答費用歸誰是同一題:AI 帳單記在資訊部門、業務單位還是專案別,往往決定一件事推不推得動。
接下來可依序核對的訊號
第一,第三方覆核。MultiLangBench 是否被獨立機構或學界採用、其他模型在同一份題目上的成績如何,決定 87.4% 是產業座標,還是自家廣告。
第二,企業實績。接下來幾季,有沒有銀行或政府機構願意具名試用、專案實際時程與花費多少,會比評測分數更有說服力。
第三,驗收工具。等價測試與行為比對若有標準化的工具或服務跟上,這條路才算打通;工具沒跟上,97.9% 就停在實驗室裡。
第四,競爭者的動作。其他模型廠是否跟進推出同類評測或遷移服務,會透露這是不是一個被共同認定的市場。
手上還有舊系統的讀者,這份報告最實際的用法很簡單:挑一段自家系統裡的 COBOL 程式,讓模型跑一輪遷移,親自驗收行為等價性。評測分數是 OpenAI 的,驗收能力才是自己要留下的。