 Techroomage
一套權重演三個角色:MASS 的進步與退步,寫在同一張成績單
Sakana AI 與柏克萊團隊讓同一個 27B 模型分飾執行、最佳化與評估三種角色,把多代理經驗回饋到微調;本文從有升有降的基準成績,整理 MASS 的運作方式、共同盲點風險與導入前的驗收順序。
Sakana AI 與柏克萊團隊讓同一個模型分工解題、修改流程、評判成果再回饋到微調,本文從有升有降的基準欄位,整理 MASS 的運作方式、共同盲點風險與導入前的驗收順序。
「1.2 至 1.6 倍」是 Sakana AI 與加州大學柏克萊分校研究團隊在論文裡報告的數字:同一個 27B 開放權重模型,經過兩輪 MASS(Multi-Agent Self-Supervision,多代理自我監督)之後,在四個研究型基準上,每輸出 token 的表現高於基準模型。同一份研究還記了另一欄:其他公開基準的分數有升有降。進步與退步同時成立,這正是自我改進這類方法最需要被驗收的地方。分數上升時,量到的究竟是能力,還是模型與測題之間的暫時合拍,答案取決於測試怎麼設計。
分數量到什麼,比分數多寡更先該問
MASS 屬於遞迴式自我改進:模型完成一輪改進後,用更新過的自己,再跑一次同類型的流程。研究要驗證的題目相當具體:讓多個代理依不同角色合作,改良它們傳遞資訊與檢查工作的方式,再從被判為較好的執行軌跡裡整理訓練訊號,回頭更新模型。實驗採用 Qwen3.6-27B 作為共同模型,訓練材料來自財務、機器人與藥學領域的合成開放式研究任務。
三個角色都由這一套權重扮演:執行者解題,工作流程最佳化者調整團隊安排,評估者比較成果。MASS 值得注意的地方,在於它把多代理協作找到的經驗帶回模型訓練;單純讓模型多回答幾次再自我打分,是另一類做法,兩者的差別就在訓練訊號從哪裡來。
不過共享模型也讓一個疑慮跟著浮上來。如果判斷錯誤的根源就寫在共同模型的偏差裡,三個角色會不會只是用不同方式,把同一個錯誤各犯一次?研究團隊也說明了結果的邊界:這是特定模型、特定任務、兩輪訓練下的某些變化。換一個模型、換一種任務、換到實際的企業流程,結論都必須重測。
內圈改流程,外圈改模型
MASS 分成兩層。內圈處理工作流程,不動模型權重。流程被寫成提示裡的一份團隊計畫,內容包含各代理的角色、任務指令、必須交回的產物,以及代理被呼叫的順序。以論文的例子來說:一個分析任務先由資料代理整理來源,交給建模代理進行分析,最後由稽核代理檢查資料是否洩漏了未來資訊。改善對準的是代理怎麼分工、交換哪些資訊、在哪個節點檢查;增加代理數量,反而不是這裡的重點。
每輪內圈執行候選流程,讓評估者比較新舊結果,再由最佳化者把評語轉成下一個可測試的安排。論文在這裡提醒了一件容易被忽略的事:只看最後的評分,團隊不會知道改變來自更好的分工、不同的工具使用,還是某次執行碰巧順利。工作流程的每個版本與中間產物都保留下來,差異才查得回來。
外圈才更新模型本身。優選流程以不同的隨機種子多次執行,由模型排序工作成果,挑出較好的對話軌跡,再以 LoRA(低秩適配,一種只新增少量參數的微調方法)訓練共享模型。更新後的模型接手全部角色,進入下一輪搜尋與訓練。訓練紀錄裡有統籌者如何拆解工作,也有子代理如何完成有限範圍的任務。
這套設計把「這次答案好不好」與「下次怎麼組隊」連在一起,代價則是訓練資料本身帶著模型的選擇。模型偏好的結果會留下來,成為下一輪的學習材料;排序準則與資料保留程序,於是都成了改進迴圈的一部分。這幾個環節若缺少獨立檢查,訓練紀錄看起來會愈來愈整齊,而整齊本身無法證明錯誤變少。
共同盲點,外部評審也解不完
團隊自己點出了最要緊的疑慮:共享盲點。三個角色底層是同一套權重,評估者的判斷能力與執行者的解題能力同源。錯誤的根源若在共同模型的偏差裡,評估者很可能照單全收;多代理結構提供的檢查力,比外觀上看起來少。
論文的補救是引入外部觀點:由另一個未參與訓練的強模型評估最終成果,評判結果不提供給 MASS 迴圈。這確實補上一個不同於自評的視角,降低訓練者拿自己的分數自我驗證的風險。但外部模型同樣受提示寫法、評分標準與自身能力影響。它是第二意見,距離客觀真值還有一段路。
有一個區分必須守住:論文觀察到的是特定測試上的表現變化;共享盲點是研究者提出、需要進一步驗證的風險,還不是每次都會發生的實驗結果。兩者混在一起讀,容易高估或低估這套方法。
評測漏看失效模式,也並非 MASS 獨有的處境。先前的評測方法研究就顯示,同一句話放在對話的不同位置,模型的讀取成功率可以差到四十個百分點,單一平均分數把這類週期性失效整個抹平。把平均分數先考倒的相位落差研究提醒的是同一件事:量測工具的解析度,決定了進步與退步能不能被看見。MASS 的成績單有升有降,恰好落在這個解析度的檢驗範圍裡。
有升有降,對導入者意味什麼
對正在評估代理系統的團隊,這份結果應該這樣讀:特定模型、特定任務組合、兩輪訓練之下,部分測項進步。它還無法回答換模型、換任務、換到公司內部流程後是否同樣成立。把局部提升當成普遍能力或部署可靠度,是這類系統最常見的跳躍。
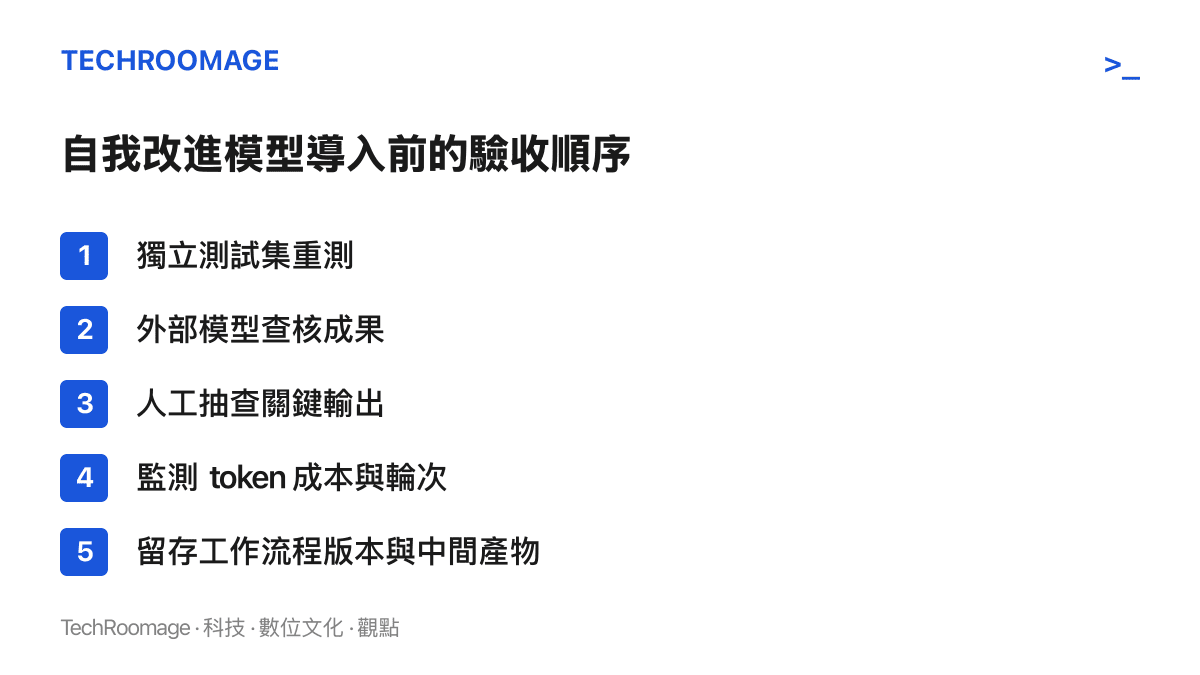
成本是另一個不能只看分數的理由。論文以每輸出 token 的表現作為指標之一,原因就在於多代理流程會放大 token 消耗:同樣的題目,多跑幾個角色、多比較幾輪,若進步只出現在特定測項,而單位成本全面上升,這筆帳就需要攤開來算。研究摘要因此把獨立測試、外部查核與成本監測並列為導入前的必要動作。
「某處變好、他處變差」的劇本,近期的模型研究裡已有前例。字節 Seed 團隊的論文先前即點出另一種性能漂移:為了省記憶體而做的設計,賠上了長對話的穩定度。錯誤從總分裡消失的方式,常常只是搬到了沒被量測的位置。導入 MASS 這類方法之前先承認這個可能性,檢查才有方向。
導入前可以依序做的檢查
把論文內文與研究摘要的建議整理成可操作的順序,大致是四步。
獨立測試放在第一步。測試集要與訓練資料、流程搜尋用過的任務分開,並納入實際場域的題目類型。研究用的是財務、機器人與藥學的合成題,使用者的業務不會相同,分數必須在自己家的題目上重新長出來。
第二步是外部查核。沿用論文的做法,讓未參與訓練迴圈的模型擔任評審;同時記得外部評審也是模型,自帶偏差,關鍵成果最好再加上人工抽查。
成本監測貫穿全程。逐任務記下 token 消耗、輪次與重試次數,與分數變化放進同一張表,改進的代價才看得見。
最後是版本留存。工作流程的每一版與中間產物都留檔,退步發生時才有材料回查:是分工變了,是工具換了,還是某次執行本來就碰巧。
下一步看什麼
MASS 的價值,在於把多代理協作找到的經驗帶回模型訓練,讓一次性的流程改良變成可以累積的學習材料。接下來可以預期,類似的自我改進設計會繼續出現,各家報告的分數也會愈來愈好看。屆時判斷的標尺或許該換個問法:與其問分數漲了多少,更該先拿到兩個答案,這些分數由誰判,以及退步發生在哪裡。答得出這兩題的改進,才進得了生產環境。
資料來源:本站編輯參考 APPI News〈Sakana AI MASS 自我改進模型可靠嗎?評測要看盲點〉(作者:張饒輝 Lightman Chang)改寫而成,原文出處;原文文字內容採 CC BY 4.0 授權。