 Techroomage
「疑似崔秀彬照片事件當事人回應」上熱搜:十四個字,三個空格
從一則十四字微博熱搜詞條的文法出發,整理疑似類傳聞的命名機制、回應者身分的判讀順序,以及照片證據在生成工具普及後的核對方法。
詞條把照片、事件、當事人、回應四個名詞全排進標題,內容卻一件都沒留在詞條裡;點開之前,可以先核對的只剩詞條本身的文法。
微博熱搜第 11 名掛著一則十四個字的詞條:「疑似崔秀彬照片事件當事人回應」。崔秀彬是 HYBE 旗下 BIGHIT MUSIC 男團 TOMORROW X TOGETHER 的隊長,2019 年出道,這個名字本身就帶搜尋量。逐字讀這則詞條,它塞進了四個名詞:照片、事件、當事人、回應,前面再加一個「疑似」。四個名詞各自指向一段內容,而這四段內容,詞條一個字都沒提。
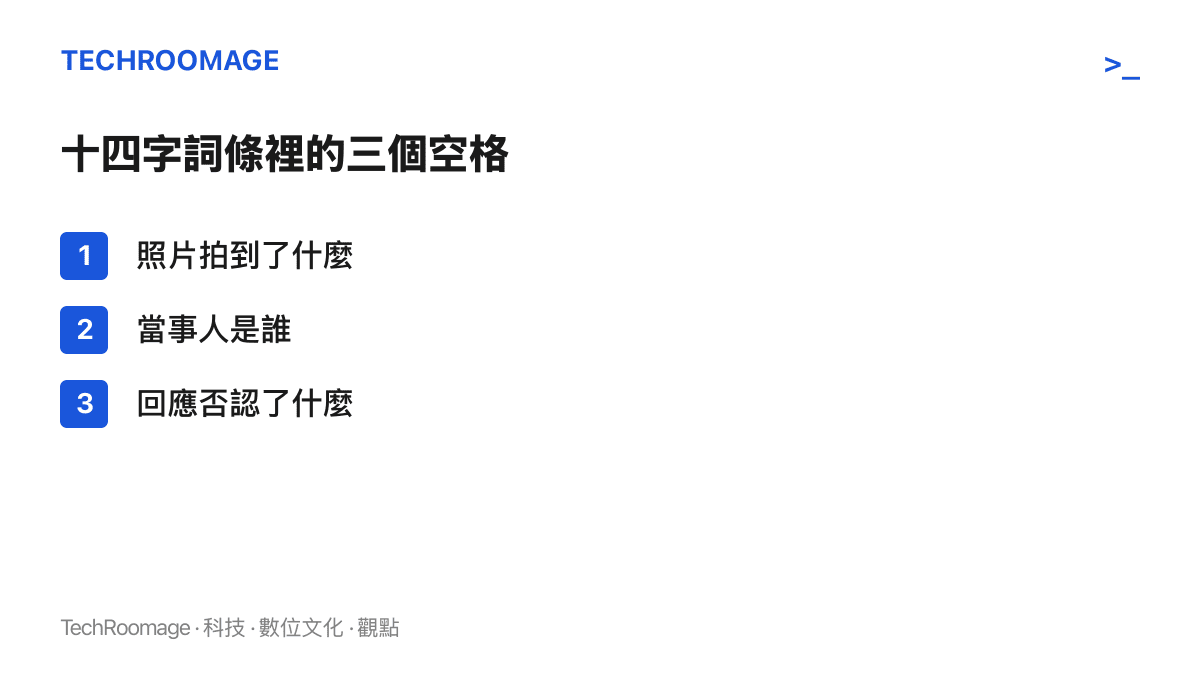
照片拍到了什麼,不知道。當事人是誰,沒寫。回應說了什麼,留在詞條外面。熱搜詞條的工作本來是壓縮資訊,這一則把壓縮推到極限,只留下傳播需要的零件:名字、事件感、進展感。事實的部分,全數外包給點擊之後的搜尋結果頁。
三個空格:名字在詞條裡,內容在詞條外
第一個空格是照片。「疑似」掛在最前面,但它修飾的範圍有兩種讀法:可以是照片裡的人疑似崔秀彬,也可以是整起「照片事件」本身處於疑似狀態。詞條不回答這個問題,反正兩種讀法的流量都一樣。名字進了標題,對熱搜與搜尋演算法來說就已經到位;「疑似」兩個字提供的是發布端的緩衝,讓帳號從頭到尾不曾斷言,至於它實際擋下了多少不實內容,詞條不負這個責。這是娛樂傳聞詞條的標準配備,也是每一波類似事件看起來都像同一個範本的原因。
第二個空格是當事人。詞條沒說回應的人是誰。照產業慣例,若說法來自藝人陣營,詞條通常會寫成「崔秀彬方回應」或「經紀公司發布聲明」;寫成無名的「當事人」,發言者更可能是照片裡被捲進來的另一方,那個沒有公司公關部門、只有個人帳號的人。閱讀順序因此很單純:先確認回應者是誰,再讀回應內容。說話的人還在匿名狀態時,回應本身就是待驗證項目。
第三個空格是回應內容。「回應」在熱搜文法裡是事件等級的動詞,它宣告故事有了新進展,但不保證進展是澄清、承認,或只是一句「不是我」。讀者點進搜尋頁之後拿到的是長篇說明還是一行否認,詞條完全不擔保。
「疑似」先完成命名,驗證留給被點名的人
「疑似」為什麼好用,看成本往哪裡流動就清楚。發布帳號用了這兩個字,事後無論事件走向闢謠還是進入司法程序,都保有退路。被寫進詞條的藝人承擔聯想成本,搜尋引擎把名字與「照片」「事件」並列,這層關聯會在結果頁停留很長一段時間。被捲進照片的人承擔自證成本,要證明「照片裡不是我」,接近證明一個否定命題,永遠比放出照片費力。收益端則清楚可見:熱搜的互動量、行銷帳號的兩輪內容、平臺的停留時間。
而且經驗上,澄清跑不贏傳聞。否認得在同一批管道裡跑第二輪,第二輪的點擊動機已經減弱,行銷帳號於是把「當事人回應」做成新標題,否認本身成了續集的材料。這套零件並不新,先前 白宇「疑似當爸」的推測鏈 就是同一種組合:一個名字,一個未經證實的狀態,加上把判斷外包給讀者的詞條。
回應的賽局:誰先說話,誰就進下一則詞條
K-pop 藝人的官方回應有一條固定管線:韓方經紀公司擬稿、法務確認、翻譯成中文、再透過官方渠道發布,時間以天計。熱搜以小時計。中間的空檔就是各種「當事人」發言的窗口,在這類事件的標準劇本裡,發言者可能是自稱照片裡的人、自稱原始流出者,或身分難以驗證的週邊帳號。個人帳號的否認即時、具名,重量卻有限;等官方聲明姍姍來遲,熱搜上的框架往往已經換過一輪。
先回應的人拿到速度,代價是成為下一則詞條的主詞。當事人再回應、當事人刪文、網友不買單,每一個都能再掛一次熱搜。這類事件的壽命,是用詞條的數量計算的。
有圖不再等於有真相
照片作為證據的地位,這兩年跌得最快。生成與換臉工具普及之後,一張來源不明的照片,預設可信度應該比幾年前低得多,傳播速度卻一點沒有變慢。中國今年九月起施行《人工智慧生成合成內容標識辦法》,要求 AI 生成的內容掛上標識;更早之前,2021 年的「清朗」行動就把粉絲圈互撕與造謠攻擊列為整治對象,平臺也陸續建了謠言標記與闢謠通道。制度約束的是生成端與平臺端的義務,照片經過翻拍、裁切、轉存,標識很容易丟失,核對成本仍落在讀者與被捲入者身上。這是此類詞條的時代背景:證據變薄,傳播不變,中間的差額由被點名的人吸收。
讀者的核對順序
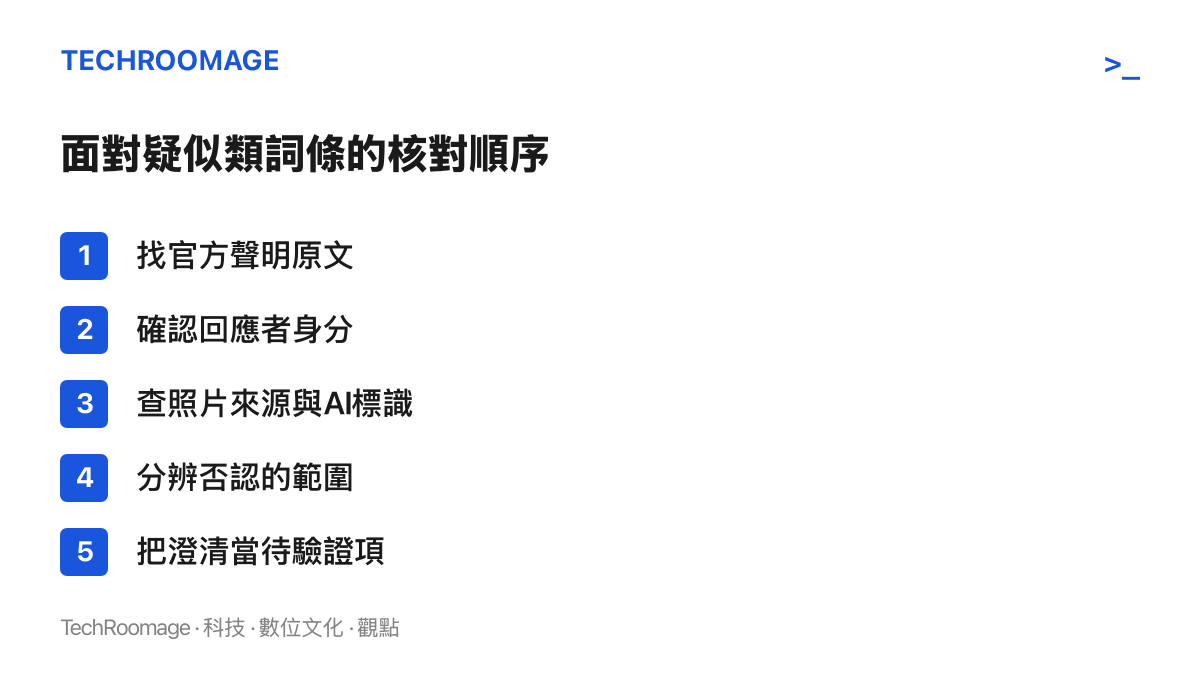
面對這類詞條,有幾個動作可以照順序做。先找官方原文:經紀公司或藝人官方帳號有無聲明,以官方頻道為準,不以行銷帳號的截圖為準。再確認回應者身分:宣稱當事人的帳號,與事件的關聯有沒有旁證。接著回看照片的來源鏈:第一次出現在哪裡、時間對不對得上、畫面有沒有生成痕跡或標識殘留。然後讀清楚否認的範圍:否認「照片裡是我」,並沒有回答照片從哪裡來,兩件事常被詞條合併成一個「回應」。最後,把澄清當成新一輪待驗證的內容,故事還沒到收尾的地方。這個順序與先前 孟子義李昀銳「真真假假」詞條 的讀法相通:詞條記下的常常只是提問,答案還在詞條外面。
之後盯什麼
幾個訊號可以依序確認:BIGHIT MUSIC 或 HYBE 是否發布正式聲明;平臺是否為相關內容掛上闢謠或謠言標記;自稱當事人的帳號後續動態,包括刪文、停用或被起底;熱搜是否長出第二輪詞條。這幾項都指向同一個判斷:在「疑似」被換成「證實」或「烏龍」之前,這則詞條真正確定的只有名字與排序,其餘都還是進行式。讀者能做的,是讓自己那一次點擊與轉發等一等,等三個空格被可驗證的內容補上之後,再決定要記住什麼。