 Techroomage
腫瘤寫成蝦滑、1 公分等於 12 公釐:湘雅二醫院 AI 論文,錯在最顯眼的地方
湘雅二醫院一份被起底的論文出現把腫瘤寫成蝦滑、單位換算出錯等十餘處常識錯誤,本文從生成模型的幻覺特徵、考核制度的需求端與醫學文獻的污染路徑,整理這起風波的讀法與後續可核對的訊號。
十餘處違背常識的錯誤走完了投稿與審稿的全程,這起風波真正該解釋的是守門機制的縫隙,以及醫學文獻被生成內容混入之後的傳播路徑。
蝦滑是火鍋配料,本來只該出現在滾燙的鍋裡。11 月 19 日起,它出現在一個完全不對的地方:貼吧網友起底的一份醫學論文被指與湘雅二醫院有關,文中竟把腫瘤的描述寫成了蝦滑。同一份論文裡,還有「1 公分等於 12 公釐」的單位換算,逐段比對的網友點出的常識性錯誤超過十處,話題詞條的即時討論累積到 1.7 萬則。
被質疑的核心只有一句話:這份論文疑似全程由生成式 AI 產出,而且從投稿、審稿到刊出,沒有任何一關把這些錯誤攔下來。
有人用 AI 寫論文,各地近兩年的學術誠信案件裡都出現過,這件事本身已經不算新聞。新的地方在於錯誤的形態。單位換算錯、食材名詞進入病理描述,都是任何受過基本訓練的讀者一眼就能指認的錯。這種等級的錯誤能走完全部流程,說明既有的檢查點對「文字通順但事實全錯」的文本沒有設防。錯得明顯的這一份被抓到了,接下來真正的問題,是那些錯得不明顯的。
錯誤的形狀:生成模型留下的指紋
細看被點名的錯誤,它們有共同的來源。生成式模型的工作方式是逐字預測下一個合理的字,它對「讀起來通順」掌握得很強,對「事實是否成立」卻沒有內建的檢查機制。「1 公分等於 12 公釐」這種錯,模型並不知道自己錯了,它在產出一段關於測量的合理句式時,連數字一起編了出來。蝦滑進入病理描述走的也是同一條路:模型在描述某種病竈的質地或影像特徵時,抓了一個質地相近的日常詞彙補進句子,語法上毫無違和,專業語意上荒腔走板。
這類輸出在業界有個通稱,幻覺。它不是偶發瑕疵,是這一代模型的固有特性。當一篇論文裡密集出現幻覺的典型形態,被懷疑 AI 代筆是很自然的推論。當然,爆料階段的判定仍來自網友比對,全篇有多少比例出自生成、作者知情到什麼程度,要等醫院或中南大學的調查才能定案。
另一個更冷的細節是,這些錯誤沒有被作者本人發現。掛名作者理應逐字讀過自己的文章,十餘處常識錯誤能一路留到刊出,幾乎說明了掛名與內容已經脫鉤。這種脫鉤在 AI 出現前就存在,論文工廠代寫、付費掛名的灰色生意運作多年,生成式工具只是把代工的產能與門檻再往前推了一大步。這與我們先前分析的非凡之愛 AI MV 的模板化生產是同一條邏輯:當內容產出被壓縮成填模板,成品就會帶著模板特有的破綻,產量越大,破綻越多。
需求端早就在,供給端剛剛到位
會有人把整篇論文交給模型,前提是體系裡存在「必須有論文」的需求。在中國的醫學教育與人事制度裡,研究生畢業、住院醫師規培結業、職稱晉升,長期與論文發表數綁在一起。這個現象官方自己都給過名稱:唯論文。教育與衛生主管部門近年推動破除唯論文傾向的改革,但考核的慣性仍在,需求並未消失。
供給端的變化才是近兩年的事。生成式工具把「產出一段看起來像論文的文字」的成本壓到趨近於零,而傳統查重系統建立在字面比對上,對生成文本幾乎無效,因為每一篇生成文字在字面上都是新的。需求沒有減少,供給卻暴增,抓抄襲的舊工具同時失靈,幾個條件疊在一起,全 AI 論文從零星案例變成可預期的現象。
貼吧的討論頁本身就是一份對照表。有網友把這次事件與先前西安交通大學一份同樣被質疑 AI 生成的論文並列;同一批討論裡,還有人翻出中山大學一名副院長的論文造假爭議,那一起與 AI 無關。對照說明的事情很簡單:學術造假的老問題早於 AI 存在,AI 沒有製造需求,它只是讓供給端的速度終於趕上了需求端的規模。也有網友把問題拉回更早的公眾記憶,問醫學界是否也要迎來屬於自己的翟天臨時刻。翟天臨事件之後,各校收緊的是學位論文查核,那套收緊是對著人設計的;當代筆者換成模型,同一套查核得重新回答一遍問題。
沒有一道關卡是為這種錯誤設計的
一份論文從投稿到刊出,通常要經過編輯初審、同儕審查、校對刊出。這套制度的設計前提有兩個:投稿者是實際做研究的人,論文是他工作的紀錄;審稿者是同領域的研究者,在有限的時間裡檢查方法與結論。制度防的是人的疏失與人對人的抄襲,抓的是邏輯漏洞和字面重複。
全 AI 論文剛好落在兩個前提的外側。作者沒有做研究,文中自然不會留下真實實驗該有的生產痕跡;文字字面全新,查重工具安靜放行;審稿者預設作者讀過自己的文章,注意力放在統計方法與結論推論,單位換算這種細節往往不在優先順序。於是最先發現問題的是體制外的人:逐字較真的網友,把截圖貼進貼吧,讓錯誤在輿論場完成學界沒有完成的那次校對。
這個劇情在其他內容領域已經演過一輪。先前的擺拍影片風波裡,媒體與大 V 集體轉發了照著轉發鍵寫的假劇本,最後把關的也是逐格看細節的普通觀眾。兩件事共用同一個機制:當生產內容的成本驟降,守門端的查證成本並沒有跟著下降,守門就會往體制外移動,移到有時間、有動機、不需要對流量負責的旁觀者手上。這不是健康的分工,這是失守後的代償。
污染往哪裡流:醫學文獻的特殊風險
學科不同,假論文的代價也不同。一份物理預印本錯了,多半浪費讀者時間;醫學文獻是臨牀決策的原料,指引的制定、系統性回顧的統計、新一代 AI 醫療工具的訓練語料,全都建立在「已發表文獻可信」這個前提上。一旦假資料進入文獻資料庫,它會被引用、被整理、被喫進下一個模型的訓練集,沿著引用鏈往下傳,撤稿也追不回已經被引用的版本。
醫院的層級放大了這層風險。湘雅二醫院是教學醫院,也是區域醫療重鎮,掛著這個名字,論文在資料庫裡自帶信任加成,被引用的機率也更高。同一個討論頁裡,已經有網友在談轉診選擇與機構信任,這類討論不會因為一次調查結束就消失,機構信譽的帳要算很長一段時間。
還有一羣沉默的付出者:在同一個評審池裡認真做研究、認真寫論文的人。當低成本的生成論文湧入期刊,審稿資源被稀釋,認真產出的辨識度跟著下降。造假的成本由全體研究者分攤,這是所有學術不端案件共通的帳單,AI 只是讓帳單漲得更快。
可以盯著看的幾個訊號
截至本文撰寫,未見湘雅二醫院或中南大學對這起爆料的公開說明。依同類案件的慣例,後續有幾個可依序核對的節點:醫院或學校是否成立調查組並公布時程;刊出該論文的期刊是否表態、是否啟動撤稿程序;署名作者的回應;最後是調查結論如何認定 AI 生成的比例,這一項幾乎沒有前例可抄,認定標準本身值得盯著看。
出版端的規範其實已經寫在紙上。施普林格與愛思唯爾等大型學術出版社近兩年先後公布政策,要求作者揭露生成式工具的使用,並明文禁止把 AI 列為作者。問題在於揭露靠自律,違規的查證依賴舉報與工具,而偵測工具還在追趕,誤報與漏報並存。規範字面上存在,執行面的縫隙正是這類論文穿過的地方,這次是被網友堵上,下次未必堵得上。
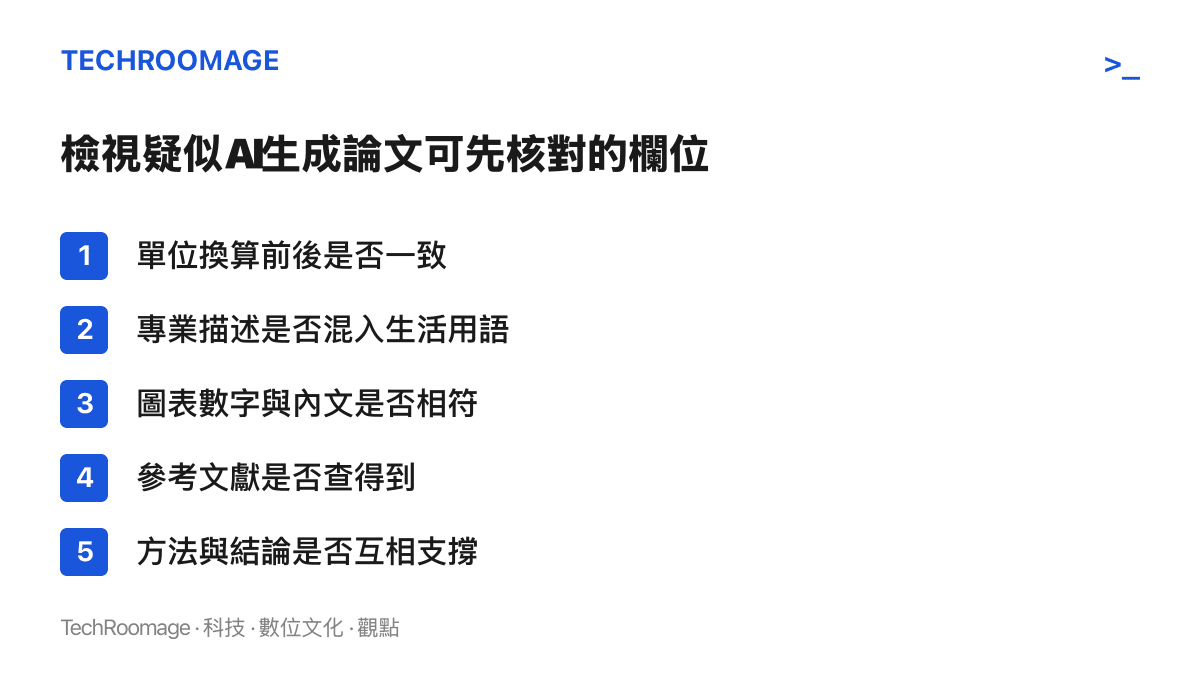
對一般讀者來說,這起事件留下的是一份可帶走的警覺。「已發表」說明的只是它通過了某套流程,流程本身不保證內容為真。單位換算前後一致嗎,專業描述裡有沒有混進生活用語,圖表數字與內文對得上嗎,參考文獻查得到嗎。這些欄位核對起來都不難,難的是在排版專業、術語滿篇的版面面前,記得要動手核對。這次替所有人上這一課的,是一份連蝦滑兩個字都沒攔住的論文。