 Techroomage
老人說女兒退休月領兩萬多:查無憑證的數字,排出全社會的級距
一則缺少單位、職級與憑證的退休金口述數字掛上微博熱搜,本文從詞條留白的傳播機制、退休收入的體系級距與並軌改革的時間線,整理集體對帳如何形成,以及讀者面對此類數字可依序核對的步驟。
一句由長輩轉述、查無憑證的退休金數字,讓熱搜留言區變成全民對帳現場;數字無法核實,級距是真實的。
一段流傳於短影音平臺的影片裡,老人替退休的女兒報出一個數字:每月兩萬多。這句話以「老人稱女兒退休每月拿兩萬多」的詞條形式掛上微博熱搜,短短一行字沒有單位名稱與職級,也沒有任何佐證。留言區的話題卻迅速離開這一家人,轉向留言者自己的父母、自己的養老保險帳戶,以及自己還要繳多少年的保費。
一個無法對帳的數字,能動員這麼多人的計算機,答案其實不在那位女兒身上,而在退休收入體系的級距裡。
詞條裡有什麼,缺什麼
先把這則詞條的資訊要素攤開:說話者是一位老人,主語是他口中的女兒,狀態是已退休,數字是每月兩萬多。四個要素湊齊,一條熱搜就成立了。真正驅動傳播的卻是它缺的東西:女兒在什麼單位、什麼職級、哪個省分退休、繳了幾年費、這個數字包不包含年金或補貼,詞條一概沒給。
留白不是疏漏,是燃料。讀到「兩萬多」的人會各自補完缺席的欄位,有人補成機關退休人員,有人補成壟斷國企的高管,也有人補成老人記錯或吹牛。補出來的版本各不相同,情緒卻共用同一個方向,就是拿這個數字去比自己的帳。這種由詞條留白、使用者補位的寫法,與先前分析過的無由頭婚戀問句也能衝上熱搜第二屬於同一套機制:熱搜只負責開題,答題的是幾千萬人。
家屬轉述還有另一層問題。家庭內部的金額本來就會在代間傳遞時失真,月領與年領混為一談、把一次性待遇攤進每個月、把存款利息或保險給付一併計入,都是常見的失真方式。一句原本只需家人核對的閒聊,被放上熱搜之後交由陌生人集體結算,而陌生人能用的資訊只有那一行字。
兩萬多落在體系的哪一級
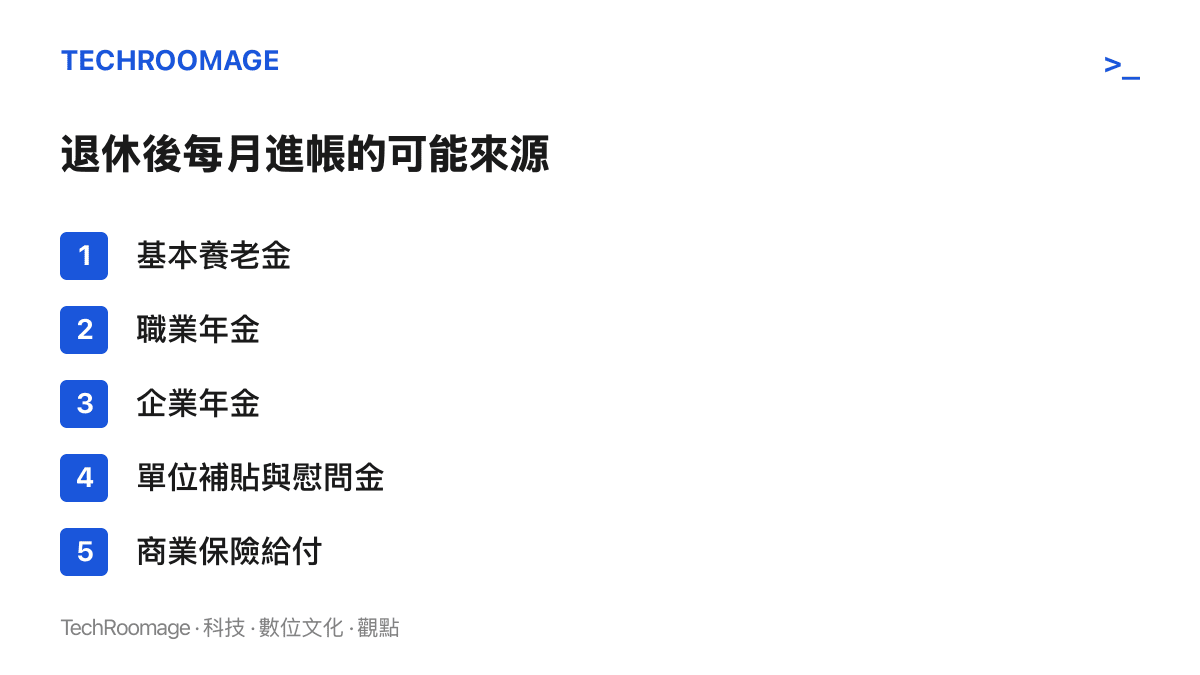
要判斷這個數字的分量,得先知道它落在座標系的哪個位置。中國的退休收入目前大致沿著兩條基本軌道加一層補充展開。城鄉居民基本養老保險覆蓋最多農村老人,基礎養老金的全國最低標準經過近年上調也只有一百多元,多數省分加發之後,實際月領仍多在兩百元上下。城鎮職工基本養老保險覆蓋企業與機關事業單位人員,企業退休人員的月平均養老金近年大致落在三千元出頭的量級。在此之上才是補充層:機關事業單位強制建立的職業年金、少數企業自辦的企業年金,以及2022年開始試點、其後推向全國的個人養老金帳戶。
在這個座標上,每月兩萬多位於最頂端的小樣本區間。它在制度上並非不可能成立:退休前職級夠高、繳費基數夠高、退休地區的計發基數夠高,也就是各地用來計算基礎養老金的基準值,再疊加職業年金,輸出的確可能達到這個量級。另一種可能是口徑問題,把補貼、慰問金、商業保險或一次性待遇合併計算後的總和。還有一種最普通的解釋,就是轉述過程放大了原本的數字。
幾種解釋指向同一個結論:這個數字就算是真的,也不代表任何羣體的一般狀態。它被當成「退休金」的代表樣本流傳,靠的是極端值在傳播上的天然優勢,而大多數實際領退休金的人,位置離它非常遠。
並軌統一了算式,起點沒有歸零
退休金差距在中國輿論場由來已久,官方也動過制度。2014年10月,機關事業單位養老保險改革啟動,結束了長達數十年的雙軌制,機關人員從過去不繳費、屆齡直接領取,改為與企業職工共用同一套繳費與計發公式。改革設了十年過渡期,2024年10月到期,過渡期內退休的「中人」按新老辦法對比保低限高,此後退休的人一律按新辦法計算。
並軌解決的是規則的統一,結果的落差卻留在公式之外。機關事業單位的繳費基數通常按全額工資申報,企業按當地下限申報的情況並不少見。職業年金屬於強制建立,企業年金卻取決於僱主意願,覆蓋的始終是少數職工。各地的計發基數差異明顯,同樣年資與職級在不同省分領到的金額可以差出一截。同一張算式,餵進不同的參數,就會輸出量級不同的結果。
這也解釋了「兩萬多」的尷尬位置:它在制度上找得到成立的組合,在大多數人的經驗裡卻夠不到。當並軌把規則統一了,而個人帳戶的明細對外部不可見,任何一個極端樣本都會被拿來代表整個體系。
熱搜上的算術題,每年重算一次
這類詞條幾乎是週期性出現的。每逢養老金年度調整、延遲退休有新進展,或有極端樣本流出,退休金差距就會回鍋一次。
驅動的力道首先來自在職與退休的對照。兩萬多超過許多在職者的月薪,當退休收入高於勞動收入,公平感的問題就自動浮上來。其次來自代際契約的緊繃:正在繳費的年輕人面對的是撫養比持續下降、部分省分基金收支承壓,以及2025年起漸進式延遲法定退休年齡這幾項已經落地的政策事實,退休對他們來說早已不是長輩的話題,而是自己帳戶裡的不確定。資訊不透明則是第三股推力,個人領多少取決於職級、地區、年限與年金,外部無從核對,於是每個極端樣本都被迫承擔代表整體的功能。
留言區在這類詞條下總會變成集體對帳現場,與先前以職場規矩量親密關係的熱搜相同,每個人交出的答案其實是自己的處境:有人報父母的退休金,也有人直接對帳自己的未來。熱搜詞條在這裡的功能類似一道開放題,平臺收走流量,作答的人各自結算情緒。
收帳之前,四個核對點
面對這類無法核實的口述數字,動氣之前有幾件事可以依序核對。
先分口徑。基本養老金、職業年金、企業年金、商業保險、單位補貼是不同的口袋,口述把它們合併成一個「退休金」的情況非常普遍,而公開討論中的平均數,通常只指基本養老金那一格。
再問身分。單位性質、職級、繳費年限、退休地區,這幾項決定同一公式下的輸出量級。缺了這幾項的數字,沒有比較基準,也無從判斷它是常態、少數還是口誤。
比對的時候,平均數與中位數要分開看。平均數容易被頂端拉高,多數人其實落在中位數以下,拿極端樣本對照平均數,得到的刺感會再放大一層。
最後回到來源本身。家屬轉述、街訪剪輯、無出處截圖都屬於低可信來源。對無法對帳的數字,比較合理的用法是當成討論的引子;要當成事實引用,先降權處理。
這則詞條不會是最後一次
只要級距存在、而明細不可見,任何一個極端的口述數字都具備掛上熱搜的全部條件。「兩萬多」的女兒只是最新一個版本,先前幾年都有結構幾乎相同的詞條流傳過,敘事骨架從來沒變過:一個說話的人、一個缺席的主語、一個多數人夠不到的數字。
對讀者來說,這類訊息的真正用處,是它逼出來的兩個問題。第一是自己站在級距的哪一格:養老保險的繳費紀錄可以查,官方與各地的試算工具可以按,年金覆蓋狀況可以問人事,把「退休後領多少」從傳聞換成自己的數字。第二是當第一支柱的替代率有限成為長期趨勢,個人養老金帳戶與自儲蓄已經是政策明文開放的補位選項,這部分的準備責任,正在從單位移回個人手上。
熱搜會退,級距不會跟著退。下一則同款詞條出現時,與其替那位查無蹤影的女兒對帳,不如先把自己的那一格算清楚。