 Techroomage
跑得通不等於答得對:LangSmith 給 AI 應用留現場、發考卷
用行車記錄器與模擬考兩個比喻,說明 LangSmith 如何記下 AI 應用每次執行的內部軌跡,並以固定題庫與自動評分,把 RAG 與 Agent 的品質變成可以反覆比較的成績單。
抽二十個問題、隨口問一輪、答對就點頭,這是多數 RAG 專案上線前的品質檢查儀式;LangSmith 想換掉的正是這套儀式。
兩個遲早會撞上的問題
挑一批問題、人工問一輪、看起來會動,就宣布系統可用。問題出在第二天:有人改了一段提示詞,沒有人說得清這一版比上一版好還是差。10 月 3 日,掘金作者東風破_ 發布一篇 LangSmith 教學,開頭就把工程師遲早撞上的兩個問題排得很整齊:程式能跑,但內部到底發生了什麼?以及,它到底好不好?
先解釋兩個名詞。RAG(檢索增強生成)是讓模型回答前先去查資料的做法;Agent 則是把檢索、工具呼叫、判斷串成多步驟執行的程式。兩種應用都有一個共通特性:你看得見輸入和輸出,中間是黑的。一次請求經過了哪些節點?檢索器回了什麼文件?模型真正收到的提示詞長什麼樣?哪一步最慢、token 花在哪、出錯時錯在哪個環節?這是第一個問題,「看不見」。
第二個問題更麻煩,「考不過」。靠人工問幾題只能得到主觀感受;教學裡的講法是,真正進入工程階段之後,需要的是可觀測、可回歸、可量化。
一句話講清楚
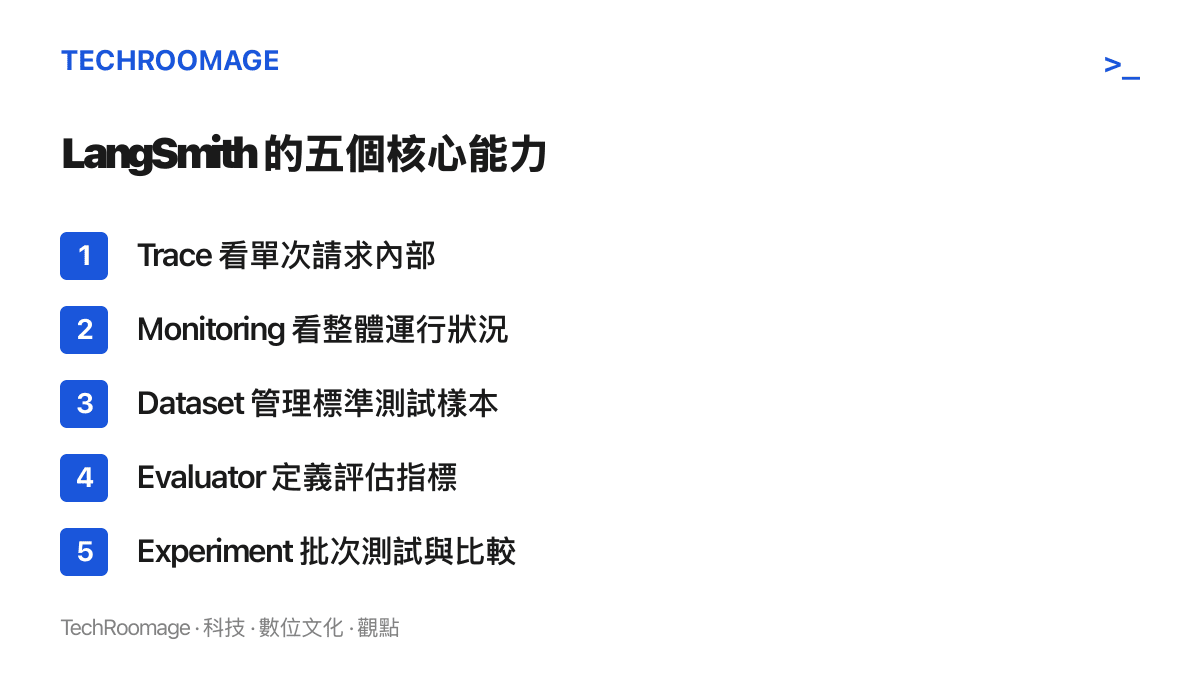
LangSmith 是 LangChain 團隊推出的觀測與評估平臺,它做兩件事:把 AI 應用每次被呼叫的過程記成樹狀軌跡,並讓你用固定的測試樣本與評分標準,反覆替應用考試。教學把它的功能整理成五個能力,各自對應一個具體問題:Trace 看單次請求內部發生了什麼、Monitoring 看一段時間內整體運行狀況、Dataset 管理標準測試樣本、Evaluator 定義評估指標、Experiment 批次跑測試並比較結果。
為什麼傳統測試接不住這類應用
傳統軟體測試的假設是:給定輸入,輸出可預期,所以可以斷言輸出等於預期值。LLM 應用的輸出是開放文本,同一個問題問兩次,措辭就不一樣,斷言相等這招直接失效。再加上 RAG 與 Agent 是多元件的組合:檢索器、提示詞模板、模型、工具呼叫,任何一環變動都會影響結果,而元件互動若沒留下紀錄,除錯只剩印日誌重現一途。
這個處境和先前談過的Comfy API 上線前的檢查清單是同一種提醒:本機跑得通,只證明了你這臺電腦,證明不了產品。差別在於,LLM 應用連「跑得通」的定義都更模糊,因為能回傳答案和回傳好答案是兩回事。
接入:三個環境變數
接觸門檻低是 LangSmith 的一個實際優點。到 smith.langchain.com 建立 API 金鑰,在既有專案的環境設定檔加三個變數:LANGCHAIN_API_KEY 負責身分認證、LANGCHAIN_PROJECT 決定軌跡歸屬哪個專案、LANGCHAIN_TRACING_V2 設為 true 開啟追蹤。設定完成後,LangChain 與 LangGraph 的執行過程會自動上報,不用改程式碼。
一個容易混淆的點值得單獨記:LANGCHAIN_API_KEY 給 LangSmith,OPENAI_API_KEY 給模型服務,兩把金鑰分屬兩條線。教學範例用的是相容 OpenAI 介面的 qwen-plus 搭配 Milvus 向量資料庫,模型照常由原本的服務呼叫,LangSmith 從頭到尾不碰你的業務模型。打個比方,它像裝在車上的行車記錄器:記錄器不負責開車,車照樣由你原本的引擎驅動。
軌跡與監控:工序單與門診報表
開啟追蹤後,每次請求在 LangSmith 介面上是一棵樹。最上層是這次執行的入口,往下展開每個節點:檢索器回傳了哪些文件、組好的提示詞全文、模型的輸出,每個節點附上耗時與 token 消耗。教學裡特別示範了一個會故意丟出例外的節點,錯誤會停在實際發生的那個 Run 上。用廚房來比喻,一道菜被客訴太鹹,軌跡就是那張記下備料、調味、火候每一步的工序單,問題出在備料還是爐火,翻單子就知道,不必靠猜。
Monitoring 則把視角從單筆拉到一段時間。延遲分布、錯誤率、成本、常見的失敗模式,這些指標回答的是「這一週整體運行得怎麼樣」。單筆軌跡像驗屍報告,事後查因;監控像門診報表,看趨勢。兩者解決的都是「看見」,但看見只完成了一半。
考試的那一半:題庫、閱卷與模擬考
後半段的三個能力,用學校考試來理解最省力。Dataset 是題庫:把真實使用者的問題、預期答案、理想的檢索來源整理成固定集合,此後品質討論的單位從「我覺得」換成「第 37 題」。Evaluator 是閱卷規則:可以寫死成程式判斷,例如答案有沒有引用指定文件、長度是否在範圍內;也可以派另一個模型當閱卷老師,按你給的標準打分。Experiment 是模擬考:換模型、調檢索參數、改提示詞之後,拿同一份題庫批次重考,歷屆成績並排比較。
這正是回歸測試在 LLM 應用上的對應物。傳統專案靠單元測試擋住壞的改動,這裡靠題庫分數擋住變差的提示詞。精神上也與BootLoops 對 AI 科學計算的要求相通:輸出的可信度來自能否被另一種方式檢驗,而不是來自模型講得流不流暢。
對你的影響與代價
什麼時候需要它?第一個 demo 階段不需要。幾個訊號出現時就到了:改一版提示詞,說不清跟前版誰好;使用者客訴答案變差,伺服器日誌裡卻什麼線索都沒有;每次換模型都得從頭手動試一輪。這些情境共同的特徵是,變動已經常態化,而驗收還停留在隨口抽問。
代價也要先算。追蹤會把提示詞內容、檢索到的文件與模型輸出送往 LangSmith 的雲端,涉及個資或客戶機敏文件時,這些內容能不能離開自己的基礎設施,是導入前要和資安單位確認的第一題。另外,當閱卷老師的是模型時,閱卷本身也會出錯,評分標準需要定期人工抽驗,否則你只是把主觀感受外包給另一個模型。
回到開頭那套儀式。LangSmith 沒有讓 AI 應用自動變好,它做的是讓「有沒有變好」這件事可以被證明。下次再憑手感說出「這版好像比較順」的時候,那就是個提醒:該把那二十個隨口問的問題,整理成一份有編號的題庫了。