 Techroomage
發布說明寫了支援,手上模型還沒點頭:llama.cpp 0.7.0 推測解碼的驗收順序
說明 llama.cpp 0.7.0 新增的兩條推測解碼路徑的運作原理與啟用條件,並整理升級前後用固定條件對照延遲、輸出內容與資源開銷的驗收方法。
LiliCorr 與 GLM5-Next MTP 進了版本說明,但功能入列與部署可用之間,還隔著相容性檢查與固定工作負載實測兩段路。
看到「推測解碼」出現在更新說明裡,直覺反應多半是:本地模型要變快了。方向沒錯,順序卻經常顛倒。在問快多少之前,更前面的問題是手上這套環境接不接得上新功能:目標模型、草稿路徑、推論後端與編譯條件,任何一環對不上,速度比較就沒有基準點。llama.cpp 在 2026 年 10 月中旬釋出的 0.7.0,一次放進兩條推測解碼路徑,LiliCorr 與 GLM5-Next 的 MTP 支援。對在本地跑模型的人來說,這代表多了測試入口;實際效益,仍要回到各自的模型與工作負載裡找答案。
版本說明裡的兩個新名字
0.7.0 的發布說明列出兩個與推測解碼直接相關的項目。LiliCorr 的完整描述是「candidate selection with a small draft transformer on top of DFlash」,在 DFlash 草稿的基礎上,疊一個小型草稿 Transformer 負責候選選擇。GLM5-Next 的 MTP 支援則與最佳化的稀疏注意力路徑一同出現,屬於為特定架構開的路徑。
同一次更新也動了推測解碼的周邊。draft sampling 與 rejection handling 獲得修正,新參數 —spec-draft-n-ubatch 讓草稿的批次大小可以與主模型分開設定。這些項目有一個共同性質:它們說明程式碼多了哪些入口,沒有對任何模型或後端承諾固定的加速幅度。
草稿先寫,正模型批改
要判斷這些入口值不值得打開,得先明白推測解碼在省什麼。語言模型生成文字的方式是逐 token 前進,每產出一個 token,就要把整個模型跑一遍。輸出愈長,這個序列就拉得愈長,延遲也隨之累積。
推測解碼的思路是讓一條輕量路徑先猜。草稿端先提出一批候選 token,目標模型再一次驗證這批候選。候選被接受,目標模型等於用一次批次處理換到多個 token 的進度,序列裡的等待次數減少;候選被拒絕,就要回頭重算,先前花在草稿上的時間與算力同時認賠。整體效益因此取決於兩個變數:候選的接受率,以及草稿本身的花費。輸出內容愈規律、愈好猜,候選愈容易整批過關;任務愈發散,賭錯的機率就上升。可以想成實習生先擬好幾行文稿,資深編輯一次審完。審一批與審一行的成本相近,省下的時間全看實習生的命中率,而編輯重寫的部分,就是付出去的草稿成本。
MTP 走的是另一條路。Multi-Token Prediction,多 token 預測,由模型內部的預測頭或相關結構直接提出後續候選,不需要另外載入一個獨立的小型草稿模型。草稿與主模型同源,配對問題少一層;代價是這條路徑長在特定架構上,GLM5-Next 有,別的模型未必有。LiliCorr 則落在兩者之間,它仍走外部草稿的路線,只是把怎麼挑候選交給小型草稿 Transformer。對使用者來說,這代表除了目標模型的檔案,還得確認草稿端的資料與轉換流程存在,否則入口開著,路上沒有車。
從「支援」到「能跑」之間
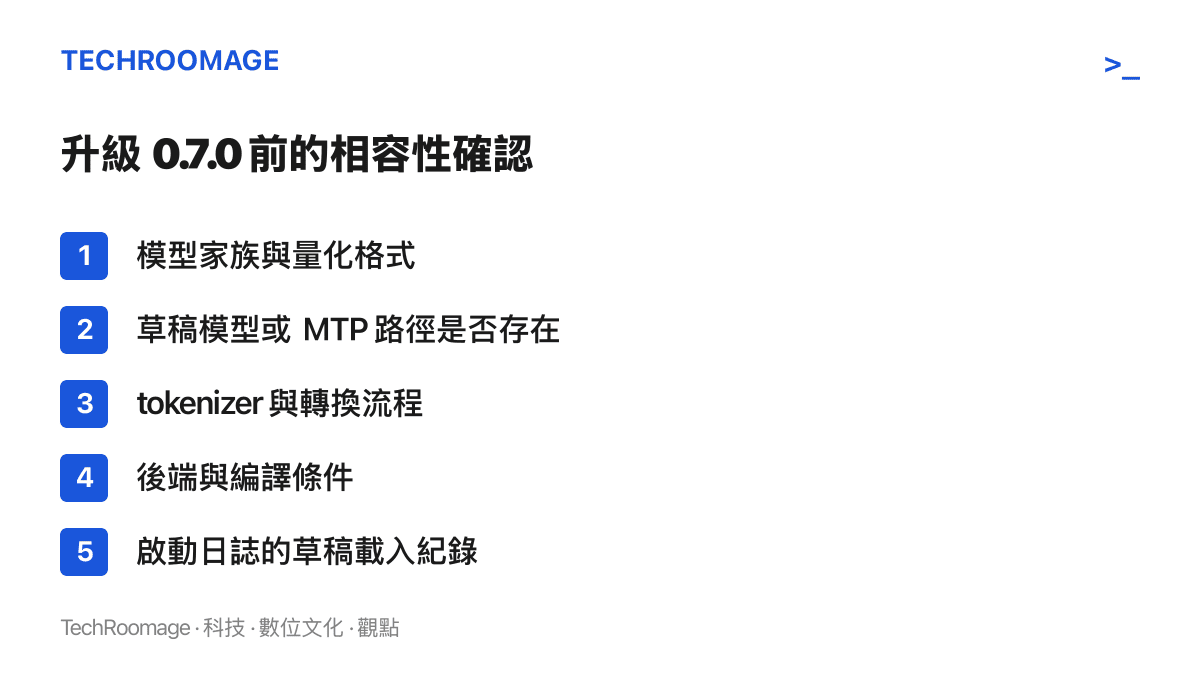
版本說明寫「支援」,通常指程式碼新增了相應的架構或推論邏輯。能不能在特定環境啟用,還要過幾道檢查:模型格式、必要權重、tokenizer、模型轉換工具、執行參數,以及後端是否具備對應的算子。目標模型載入成功,也推不出草稿或 MTP 路徑已經生效,證據要往啟動日誌、生成過程與最終輸出裡找:草稿有沒有被載入、接受率輸出是否合理、生成結果有沒有異常。
草稿模型若需要單獨載入,紀錄項目還要再加幾項:它與目標模型的對應關係、檔案版本、量化方式。模型名稱相近,架構與 tokenizer 未必相同,憑名字配對是常見的出錯點。編譯條件也一樣。某些路徑依賴特定後端或編譯參數,升級之後先確認原本的建置設定還在同一條路上,再開始談速度。
固定工作負載,量三組數字
相容性過關之後,量測才有意義。升級前先記下三件事:目前執行的版本、模型檔來源與版本、後端與編譯設定。升級後用同一組提示詞、同樣的取樣參數、同樣的批次條件做對照。要比的數字分三組:延遲與生成速度、輸出內容、資源佔用。
輸出比對在這一版特別要緊。這次更新修正了 draft sampling 與 rejection handling,取樣與拒絕邏輯的改動,可能讓相同參數下的輸出與舊版不同。固定提示詞的前後對照,是分辨「變快」與「變了」的辦法。資源端則要看草稿路徑帶來的記憶體與算力開銷,—spec-draft-n-ubatch 的設定值也會影響分配,測試配置應該一併記錄,否則日後無法重現結果。若部署依賴 server API、啟動參數或批次請求,把這些使用路徑一起納入驗收,命令列跑得通與 API 跑得通是兩回事。
這套先記錄、再對照的順序,與我們先前整理的Apertus 1.5 升級前的五項檢查是同一種紀律:能力、資源帳與相容性先對齊,版本號本身回答不了其中任何一題。能把新功能的可能性轉成證據的,只有固定條件下量出的那組數字。
之後值得盯的訊號
把視野拉遠一點,這次更新透露的方向有兩個。其一是草稿持續從外部模型移進模型本身。MTP 這類內建預測頭的設計,把「配一個好草稿」的責任從使用者移回模型作者,llama.cpp 為 GLM5-Next 開了路,接下來值得看哪些模型家族跟進,以及轉換工具鏈何時補齊。其二是基準資料的供給。目前發布說明只給入口,沒有提供適用各模型的接受率或加速數據;若官方或社羣補上這類資料,使用者的驗收成本會明顯下降。
在那之前,任何轉手的測試數字都值得先問一句:用哪個模型、哪個後端、哪種工作負載量出來的。換了方法之後,進步與退步常寫在同一張成績單上,MASS 的測試結果就是有升有降的實例。推測解碼也一樣,任務與模型換掉,結論的方向就可能翻面。
對在本地跑模型的人,0.7.0 的價值在於多了兩個可測的入口,至於效益,要靠一次像樣的對照實驗換回來:先確認相容,再用固定工作負載量出屬於自己的數字。這個順序比任何版本號都耐用,因為下一份更新說明出現新的加速功能時,同樣的步驟還得再走一遍。
資料來源:本站編輯參考 APPI News〈llama.cpp 0.7.0 推測解碼怎麼驗收?先看相容性與實測〉(作者:張饒輝 Lightman Chang)改寫而成,原文出處;原文文字內容採 CC BY 4.0 授權。