 Techroomage
條款裡的「訓練」收回了:Meta 商業服務條款爭議,與沒被刪掉的抓取授權
Meta 商業服務條款新增的「訓練」表述在法律專家與媒體質疑後刪除,本文整理風波經過、robots.txt 與合約授權的層次落差,以及字眼刪除後仍留在條款中的廣告用途抓取授權。
Meta 把「訓練」寫進商業服務條款的用途清單,被法律專家解讀為取得企業網站內容的 AI 訓練授權;表態稱行為不變、隨後刪除表述之餘,以廣告和商業產品為名的資料抓取授權,仍留在條款中。
「使用來自企業帳號之網域名稱、網頁或 URL 的任何內容,以提供、開發、改善、研究、訓練並維護 Meta 產品與服務。」
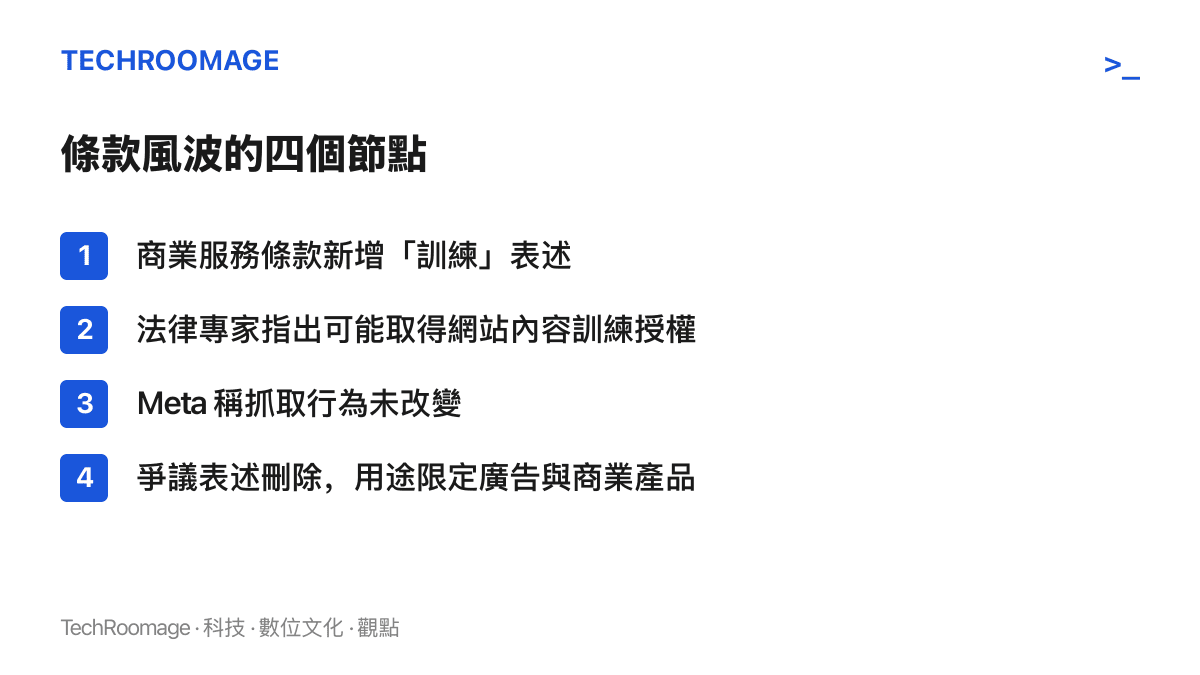
10 月中旬,這段文字出現在 Meta 更新後的商業服務條款裡,約束對象是所有使用 Meta 商業工具的企業帳號持有者。美國哥倫比亞大學新聞學院旗下的 Nieman Lab 找來法律專家檢視,得到的評語是「引人注目的條款」:照字面解讀,Meta 可能因此取得抓取任何擁有 Meta 企業帳號的內容發布商網站、並將內容用於 AI 模型訓練的權限。Meta 發言人先是強調公司抓取網路的方式並未改變;到 The Verge 報導刊出、10 月 18 日經中外科技媒體轉述時,這段爭議表述已從條款中正式刪除。
爭議以刪除收場,但收得並不乾淨。被拿掉的是「訓練」兩個字,留下來的是以「廣告和商業產品」為名的整套資料抓取授權,以及一條已經示範過一次的擴權路徑。
用途清單裡的「訓練」,把站外網站劃了進來
商業服務條款是企業使用 Meta 商業工具的前提:開設粉絲專頁、投放廣告、經營商家帳號,都以同意這份文件為起點。這類條款向來給予 Meta 範圍不小的資料處理權限,只是過往多半與廣告投放、安全防詐等用途綁定,對象也集中在站內互動資料。
這次更新的關鍵變化有兩處。資料來源從站內延伸到「企業帳號之網域名稱、網頁或 URL 的任何內容」,等於把商家與媒體在 Meta 站外的整個網站劃進條款範圍;用途清單中則出現「訓練」一詞。Nieman Lab 採訪的法律專家指出,兩者相加之後,一家開了企業帳號的媒體,官網上的文章、圖片與商品頁,理論上都可能成為 AI 訓練素材,而且授權隨帳號存續,難以逐篇撤回。
Meta 的第一時間回應沒有觸碰條款文字,而是切割文字與行為:發言人表示,更新後的條款不代表 Meta 抓取網路的方式發生改變。等到 The Verge 追蹤報導刊出,爭議表述已經刪除。Meta 在聲明中解釋,此次更新是對既有廣告條款的「合併整合」,並非擴大爬蟲行為;修改後的條款已明確限定,爬蟲與資料收集僅用於「廣告和商業產品」,並重申站長仍可透過 robots.txt 控制爬蟲權限。
robots.txt 擋得住爬蟲,擋不住合約
Meta 把 robots.txt 抬出來當保證,但兩套規則作用的層次不同。robots.txt 是 1990 年代成形的爬蟲協定,放在網站伺服器上,告訴造訪的爬蟲哪些內容可以抓取、哪些請略過;它依賴爬蟲方自願遵守,本身沒有強制力,大型平臺的爬蟲是否尊重各站設定,多年來一直是站長社羣裡的爭論題。
條款則是合約語言。企業帳號建立、按下同意的那一刻,授權就成立,與爬蟲實際來不來無關。法律專家擔心的正是這一層:一旦「訓練」寫進用途清單,就算站長用 robots.txt 擋下爬蟲,條款仍可能被解讀為已取得內容的使用授權。這也是「行為沒變」的說法難以平息質疑的原因,條款的功能本來就是提前取得權限,為之後的行為預留空間。
在個人使用者那一側,Meta 以公開內容訓練 AI 的政策,先前已在歐盟引來監理機關關注,Meta 也提供過異議表單讓使用者選擇退出。這次的爭議把範圍再往外推了一圈:被劃進授權範圍的,從個別用戶的貼文,變成企業帳號連結的整個網站。
字眼刪除後,留下的是整包授權
依 Meta 修改後的說法,抓取與收集資料的用途限定於「廣告和商業產品」。換句話說,企業帳號持有者網站上的內容,仍可能被抓取用於廣告投放、成效衡量與商業功能最佳化,這部分授權並未隨「訓練」字眼一起消失。對多數商家而言,這通常被視為使用商業工具的對價;對媒體與內容發布商而言,站內外內容被統一納入商業資料流程的邊界,仍在持續外推。
條款的另一個現實是拒絕的成本。企業帳號是投放廣告與經營顧客關係的基礎,多數商家沒有逐項不同意的選項,只剩關閉帳號,或者調整 robots.txt 再自行承擔廣告成效的可能變化。同意機制在這裡沒有逐項勾選的空間,企業只能整包接受。
「合併整合」的解釋也值得細看。把散落各處的廣告條款整併成一份文件的過程中,「訓練」出現在用途清單,事後又說這不是政策變化。這顯示條款整併本身可能成為權限挪動的通道。對所有網路服務的使用者來說,這是一個可以重複使用的檢查動作:下次任何平臺宣布「條款整併、內容不變」時,逐段比對新舊版本的用途清單,比讀官方聲明可靠。
條款戰場上的其他動向
把 AI 訓練寫進政策文件,Meta 並非唯一。X 先前已調整隱私政策,允許以公開資料訓練模型;內容授權與 AI 的拉鋸也蔓延到遊戲圈,微軟為了 AI 搬運與改作遊戲的風潮,成立 XBOX Labs 研究 AI 改遊戲。Meta 這次的特殊之處在於授權路徑:把站外網站內容掛在「企業帳號」這個身分上、隨帳號關係納入,比直接改寫隱私權政策安靜得多。
時間點也難以忽視。AI 已是 Meta 全力押注的方向,稍早 Meta 開放 816B 權重後,Muse 與 Dots 帶起的常駐個人智慧體熱潮,在中文圈兩週內補齊三條替代路線。一家把產品線重心全面移往 AI 的公司,在條款用途清單裡為「訓練」預留位置,要讓外界相信這只是整理文件時的失誤,說服力有限。
後續可以依序核對的訊號:商業服務條款頁是否再次修訂、用途清單的字眼如何演變;Meta 的 AI 資料政策頁對訓練資料來源的描述有沒有同步調整;以及企業帳號後臺是否出現與資料使用相關的新設定。這場風波最終以刪除兩個字收場,但對內容發布商與商家來說,判斷標準已經清楚:平臺的資料權限,先寫在條款裡,才反映在爬蟲行為上。盯條款的版本差異,比盯新聞稿有用。