 Techroomage
Codex 用滿四年會拉開差距嗎?答案在兩本帳的餘額裡
把知乎熱門的四年之問當成分析對象,從進步分流的實證證據、根本不存在的研究對照組,與工具世代四年翻新的時間尺度,整理出每月可操作的對帳方法。
提問把技能想成一本每天存款的帳,代理工具讓存款分流:一部分記在你名下,一部分記在 AI 名下。四年後的差距,取決於你自己那本的餘額。
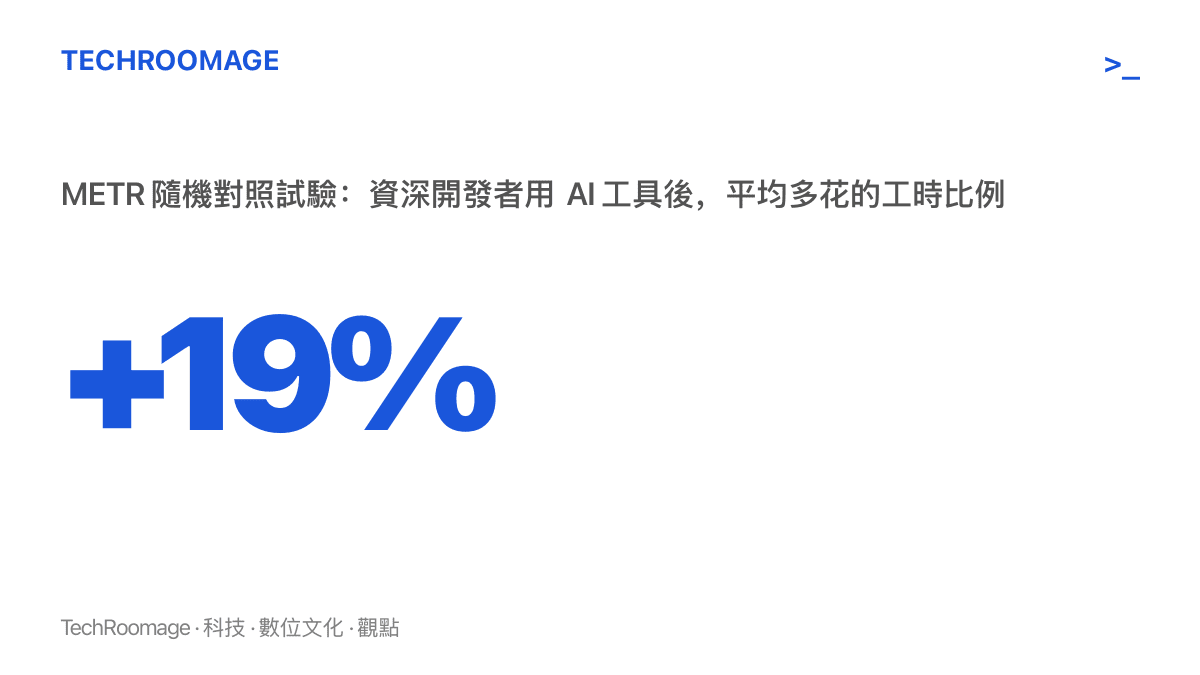
先看一個反直覺的數字:19%。2025 年年中,研究機構 METR 做了一場隨機對照試驗,找來一組資深開源開發者,讓他們在自己熟悉的專案裡解任務,一半人用 AI 工具,一半人不用。結果,用 AI 的那組平均多花了 19% 的時間。這羣人並非新手,他們比誰都熟悉這些工具,結果仍然變慢了。
帶著這個數字,再看知乎上這道熱門提問,滋味會不太一樣:「大學生用四年 Codex,每天進步一點,四年之後,與沒用上 Codex 的同學會有很大的差距嗎?」
提問預設了兩件事。其一,存在一羣「沒用上 Codex 的同學」可以當對照組;其二,「每天進步一點」會像存款一樣複利,四年後結出一筆明顯的差距。這兩個預設恰好都值得檢查。
對照組並不存在
先處理第一個預設。在一間 2025 年入學的資訊科系教室裡,找到完全不用 AI 寫程式的學生,難度可能高於找到重度用戶。沒訂閱 Codex 的同學,手上大概率是 Cursor、Claude Code、Gemini CLI,或者免費額度就夠用的通義靈碼。這些產品的能力有落差,但屬於同一代:你描述需求,它生成可執行的程式碼。
所以這道提問實際比較的,多半是「重度用戶」與「普通用戶」,兩邊都站在代理工具的時代裡。單純「有沒有接觸 AI」這個變數的解釋力只會越來越弱,就像今天沒有人因為「會用 Git」在履歷上獲得加分。真正的變數藏在用法裡,這點後面會回到。
為什麼是現在問這題
程式輔助工具在近兩年跨過一道門檻。從補全單行、生成函式,到能在終端與雲端領工單、跑測試、改檔案的代理,工作單位從「一行」變成「一項任務」。Codex 這個名字的履歷可以說明變化有多快:2021 年,OpenAI 用它稱呼驅動 GitHub Copilot 的程式碼模型,2023 年除役;2025 年同名產品回歸,這次是代理。四年之內,同一個名字指過兩種不同的東西。
這帶出討論這題時最常被忽略的時間尺度。四年,在代理工具的世代裡是地質時間:一個 2025 年入學的學生若把職涯押在某個特定工具上,畢業時那個工具的形態大概又換過一輪。押注工具本身是脆弱的,這幾乎是提問裡唯一能先確定的結論。
提問會熱,還有課堂端的因素。作業邊界被打穿之後,同一門課的學生悄悄分成兩條路線:一條用 AI 把作業寫完,一條用 AI 把作業學會。兩條路線的產出在外觀上難以區分,計分方式一時也跟不上,分流就這樣在校內無聲進行。焦慮則來自推甄研究所與爭取實習的時程:差距什麼時候變成不可逆,沒有人給得出答案。
進步會分流,記在兩本帳上
第二個預設把技能想成一本帳:每天存一點,餘額就是能力。代理工具出現後,存款會分流。AI 接手的環節包括語法記憶、樣板程式碼、API 用法回憶與框架設定;留在你手上的,是把模糊需求寫成明確規格、判斷生成結果對不對、跨檔案除錯,以及決定哪個方案值得留下的品味。
每天用 Codex,四年的「進步」按比例落進兩本帳。工具那本增長飛快:專案跑得動、測試是綠的、成品看起來很完整。你這本的增速,取決於你有沒有逐行讀懂送出的程式碼,有沒有在代理出錯時自己接手。帳面產出可以完全一樣,帳本內容天差地別。
心理學家 Robert Bjork 有個概念叫「必要難度」:學習發生在費力的地方,提取越喫力,記得越牢。代理工具的設計目標,恰恰是把費力消除。這不等於用工具就學不到東西,閱讀優質的生成程式碼、提早接觸真實專案的規模,都是真實收穫;但摩擦被選擇性移除了,而摩擦正是大學課程原本在教的事。
實證研究給出的圖像是分裂的。GitHub 團隊 2022 年的實驗裡,開發者用 Copilot 實作一個 HTTP 伺服器,速度加快約 55%。哈佛商學院與 BCG 合作的顧問實驗則發現,AI 在能力範圍內的任務能提升表現,範圍外的任務,過度信任 AI 的人反而更容易出錯。把這些與 METR 的 19% 放在一起看,方向其實一致:速度增益是真的,但集中在模型本來就擅長的任務;一旦任務越過能力邊界,成本就轉移到驗證端,而驗證端記在你自己的帳上。
驗證成為新瓶頸,別的領域先碰到過。資安圈今年的案例:AI 掃出的候選漏洞大量增加,Mozilla 把其中 271 個修進 Firefox 150,真正的關卡移到驗證與修補的消化速度。寫程式的場景相同:生成端產能過剩,消化端定義實際產出。
每一波工具,都把考題往上移一層
歷史上有現成的鏡子。計算機進入數學課堂後,考試把運算交給機器,比分移到建模與應用題。Stack Overflow 世代,背 API 用法貶值,判斷答案可信度升值。每一波工具都壓縮某一層技能,衡量標準就往上移一層。這一波壓縮的層數多了些,從語法一路壓到初步設計,所以衡量標準會移到更高處:定義問題,以及驗收結果。
同一種位移也出現在其他內容工作。電競內容圈今年的說法是,會打比賽的 AI 還沒到,會講比賽的先上工了:生成端先被接手,判斷與驗收留在人這邊。工程工作的分界線位置不同,方向一致。
另一半的預設也該翻過來看。「沒用上 Codex 的同學」若真的手寫四年,他那本基礎帳會很厚:資料結構與演算法的基本功,加上硬啃出來的除錯直覺,白板題多半佔優勢。但工作流程那本偏薄,而畢業後接手的,是代理時代的程式碼庫。兩邊各有一個缺口要補,提問卻假設只有一邊有差距。現實是兩邊補的東西不同,補的速度也不同。
可用的判斷:每月對一次帳
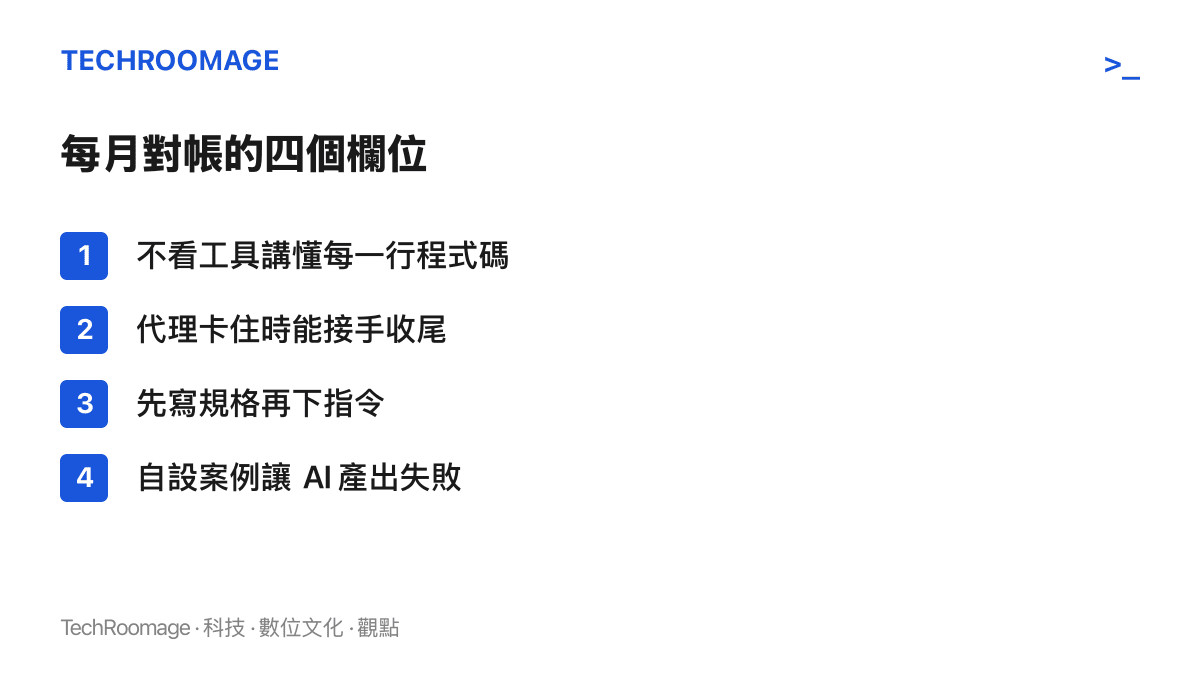
與其問四年後有沒有差距,不如每個月做一次對帳。項目不必多,四題就夠:
- 關掉代理,能不能講懂上個月送出的每一段程式碼?
- 代理在錯誤裡繞圈時,有沒有能力接手收尾?
- 下指令之前,能不能先把需求寫成清楚的規格?
- 有沒有自己設計過讓 AI 產出失敗的測試案例?
四題都過,每天的進步確實記在你名下;四題都卡,進度感很強,餘額記在工具那邊。METR 那批資深開發者變慢,一部分原因正是在對帳:審查生成結果的成本真實存在,也真實必要,省掉這道工序的人,把成本轉成了看不見的負債。
回到原提問。差距會有,但決定差距的變數,已經從「用不用 Codex」移到「每天的進步落在哪本帳」。工具的世代四年會翻好幾輪,規格撰寫、驗證、除錯與品味這幾欄卻會留下來,因為它們是代理跑不掉、也交不出去的工作。與其押注某個工具,把對帳紀律練成習慣,是目前比較穩的做法。