 Techroomage
找到不等於修好:GPT-6 Cyber 的 948 個漏洞,停在驗收中段
解釋 OpenAI 資安研究公告中各項漏洞數字所對應的驗證階段差異,並整理一般讀者與資安團隊面對此類消息時可依序核對的重點。
OpenAI 這份 Linux 核心研究裡,每個數字都對應一種驗證狀態;分不清數字停在哪一站,新聞就會被讀成另一回事。
「AI 在 Linux 核心找到 948 個可利用漏洞」,這句話的直覺畫面通常是修補包即將全面發布、各種裝置命懸一線。翻開 OpenAI 於 2026 年 11 月初公布的研究說明,948 其實停在驗收流程的中段:它前面有一串被篩掉的候選,後面還有 Linux 維護者的審查沒走完。要讀懂這則新聞,關鍵在於弄清楚每個數字停在流程的哪一站。
先用一句話講清楚
GPT-6 Cyber 是 OpenAI 面向資安研究的模型,這次展示的是一條分成多站的工作流程:挑出值得看的程式碼,提出候選缺陷,在隔離環境裡重現,判定能否實際利用,最後起草修補。每個站點產出的數字各代表一種身分,把不同身分的數字壓成同一句話講,是這類新聞最常見的失真方式。
280 萬行程式碼,先縮小巡邏範圍
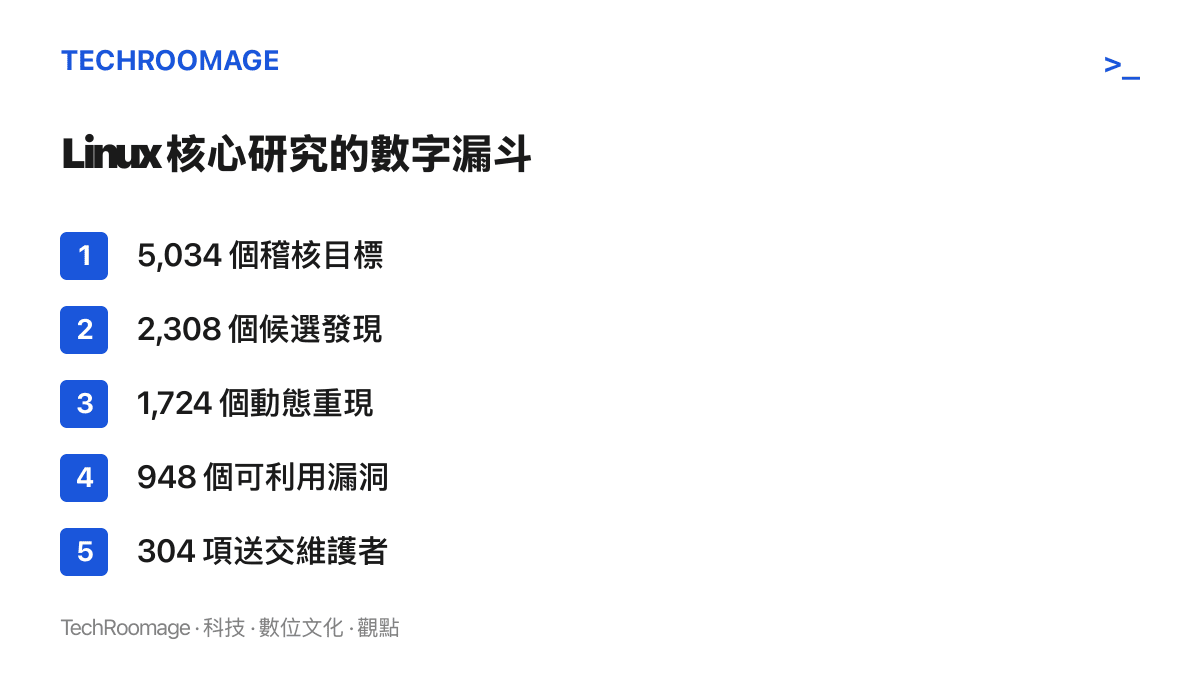
Linux 核心太龐大,全部細看不現實。研究第一步由 Scout 代理執行,挑出低權限使用者碰得到、且與安全相關的區域,得到 5,034 個稽核目標,合計約 280 萬行程式碼。這一步像先把巡邏範圍從整座城市縮到幾條明確的熱區,沒被選進熱區的地方不代表沒問題,只是這一輪不看。
Analyst 代理接手後逐項分析並去重,產生 2,308 個候選發現。「候選」兩個字要照字面理解:代理認為這裡可能有缺陷,但還沒證明特定輸入能觸發它,也還沒界定影響範圍。所以每筆回報都該保留程式位置、觸發前提、理由和驗證狀態,後續接手的人才查得下去。
候選接著進入動態重現。代理在隔離的虛擬機裡執行最小重現測試,過程使用 KASAN,這是 Linux 核心圈常用來抓記憶體錯誤的檢查工具,作用像裝在核心裡的行車紀錄器,程式碰到不該碰的記憶體位置就會留下紀錄。代理依程式輸出與系統訊息反覆調整,直到重現或放棄。最終 1,724 個候選成功重現,約佔四分之三;其餘有些需要更高權限才碰得到,有些受限於競爭條件與時間因素。
重現之後還剩兩件事:去重與判定。變體分析把同一個漏洞被重複回報的結果合併,剩下 948 個不同的本機權限提升漏洞,而且每個都有可工作的利用程式。
重現了,還不表示能利用
「本機權限提升」值得停下來解釋。它指攻擊者已經能登入機器、手上卻只有低權限帳號,漏洞讓他取得更高的系統權限。這與遠端免登入的直接入侵屬於不同攻擊面,後者才是一般人腦中的駭客場景。研究團隊是在具備標準發行版防護的虛擬機裡測試,換句話說,這些利用在接近一般部署條件的防護下成立,但場景仍是實驗室。
另一個容易算錯的地方:948 是「不同漏洞」的數量,經過變體分析去重,並非成功利用嘗試的總數。同一份文件裡的數字各有各的計算口徑,這種閱讀紀律先前在幣安事故公告裡兩個不能相加的數字也派得上用場。
四種身分,分站驗收
把整條流程的狀態整理出來,共有四種:候選發現、已重現漏洞、可利用性判定、可合併修補。它們聽起來像同一件事的進度條,實際上各有各的證據要求和責任人。
用健檢來比喻比較好懂。候選發現像健檢報告上的紅字,重現像複檢確認異常存在,可利用性判定像確診並且分期,候選修補像治療方案,而簽名權在主治醫師手裡。紅字多,只代表篩檢抓得多,離出院還很遠。
OpenAI 描述的輸出包含根因分析、最小重現程式、候選修補和利用證明。研究人員拿到後還要檢查兩件事:利用程式是否真的走了指定漏洞的路徑,修補是否完整。檢查通過,才依 Linux 社羣指引回報。目前 304 項關鍵發現連同候選修補已送交維護者,其餘仍在處理。要特別注意的是,候選修補沒有任何一個等同於維護者已接受的正式版本,能不能進主線,決定權在維護者手上。
Firefox 與工控,另外兩份成績單
同一批公告裡還有兩個案例,常被與 Linux 的數字混著講。
Firefox 案例同樣由 OpenAI 研究人員操作模型,結果有兩筆。第一筆,模型找出 81 個經 Mozilla 分類為高嚴重度的新漏洞,附上重現測試與候選修補,Mozilla 收到通報後已開始釋出修正。第二筆,模型指出 30 個已知問題的嚴重程度高於原先評估。前者是新發現,後者是對既有判斷的重新評分,兩筆數字不該加總成一個 headline。
工控場域的測試由 Dragos 執行。這家工控安全廠商在 2026 年夏末受 OpenAI 委託,以 GPT-5.5 Cyber 與 GPT-5.6 Sol 進行七項探索性評估。報告記錄模型在電力工程軟體找到兩個未知漏洞;在模擬水管線網路的測試中,評估者先提供子網與網路存取,模型經動態測試後使 MicroLogix PLC 停止回應;另一項 HMI 測試則造成 FTP 服務中斷。報告沒有提供基準比較,也沒有整體誤報率。這層保留與ForTy 森林地圖整體九成、人工林只剩五成八的落差是同一課:模型在特定測試的成績,不能直接推到日常使用場景。
20 個「成功」的教訓
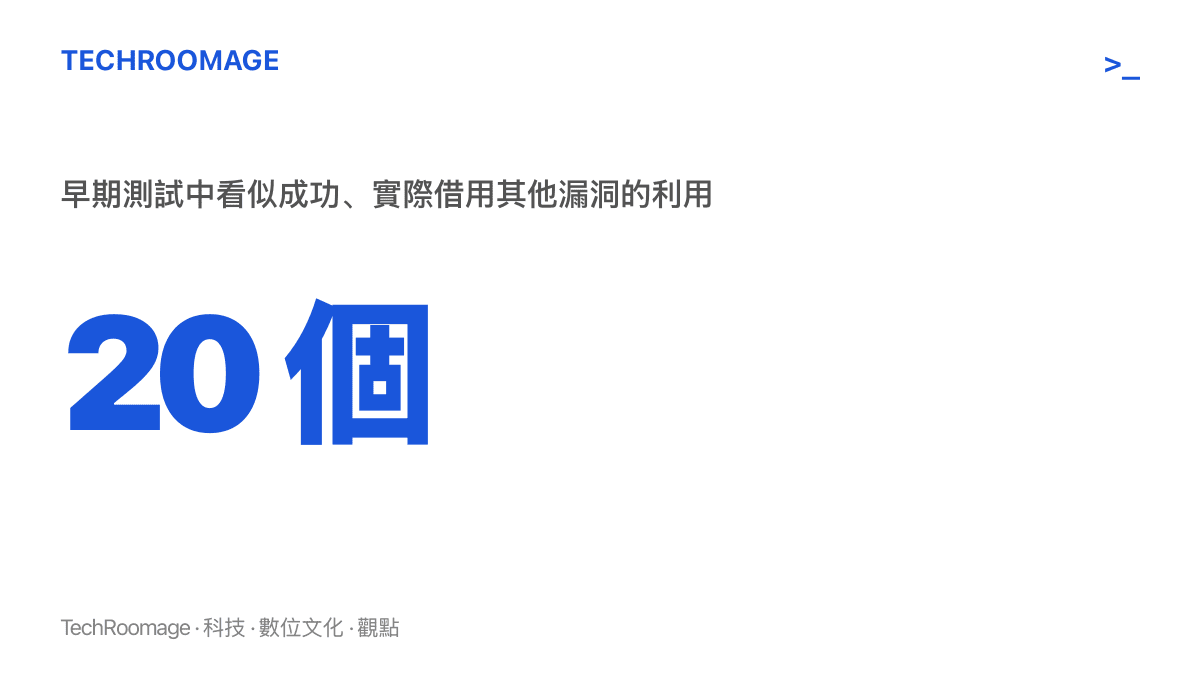
研究過程裡有個細節值得單獨看。早期測試中,有 20 個看似成功的利用,事後發現是借用了另一個漏洞達成效果。測試通過了,但通過的原因與原先假設無關。研究團隊因此加入獨立檢查,確認每個利用的攻擊路徑確實走了指定漏洞。
這條經驗對準備把 AI 掃描接進修補流程的團隊最實用。「結果成功」與「按原假設成功」是兩種驗收,跳過後者,修補可能補錯位置,帳面卻一片漂亮。
讀到這類新聞時,先對齊數字的身分
一般讀者下次再看到「AI 找到多少漏洞」的標題,可以先做一個動作:找出數字對應的狀態。是候選、重現、可利用,還是已修補?同一批發現裡,這四種數字可以相差好幾倍,而多數標題挑的是最大的那一個。
在資安團隊裡工作的人,可以直接借用 OpenAI 自己的提醒:模型分數或候選數量只描述指定測試,不足以證明日常程式碼審查能達到相同成效;派工時不能只依模型標示的嚴重度,要看每筆回報的證據與責任人。已經把掃描接上修補流程的團隊,重點則放在逐站驗收的證據是否齊全。
接下來最值得追蹤的訊號在維護者那一端。已送交的 304 項發現,哪些被接受、哪些被退回、退回理由是什麼,會比任何一次性的大數字更能說明這條 AI 找漏洞的路,目前真實走到了哪裡。
資料來源:本站編輯參考 APPI News〈GPT-6 Cyber 如何找漏洞?研究流程、限制與團隊驗收〉(作者:張饒輝 Lightman Chang)改寫而成,原文出處;原文文字內容採 CC BY 4.0 授權。