 Techroomage
三十二分鐘跑完小鼠全腦資料:AI 代理把線索變便宜,驗證仍是原價
整理 OpenAI、PerturbAI 與 Scripps Research 的分散式代理流程如何平行解讀小鼠腦部 CRISPR 資料,覆蓋率數字該怎麼讀,以及候選線索交給人工複核與實驗驗證的分工界線。
OpenAI、PerturbAI 與 Scripps Research 以數千個代理平行整理 CRISPR 腦部資料,把文獻覆蓋推到人力之外;產出的每一條解釋都還是候選線索,要靠人工複核與實驗驗證分層把關。
一份小鼠全腦的 CRISPR 圖譜攤在眼前,接下來的工作是逐項解讀基因擾動後的細胞反應、核對細胞分類與實驗條件、查找相關文獻,再判斷哪些變化值得設計後續實驗。研究團隊對這種逐一處理的估算,是數個月到一年。OpenAI、PerturbAI 與 Scripps Research 最近展示了另一條路:數千個由 GPT-Rosalind 驅動的 AI 代理,三十二分鐘跑完既有實驗資料,彙整出一份可供研究者追查的推理圖譜。
速度的差距容易被記住,也容易被誤讀。這套流程沒有執行新的生物實驗;代理做的是對既有資料的平行解讀,產出的每一條解釋,身分都是候選線索。判斷它能不能進入研究流程,要看任務切分是否合理、證據能否追溯,以及候選假說能否順利交到人工複核與實驗驗證手上。
瓶頸不在定序端,在解讀端
CRISPR 擾動實驗的邏輯並不神祕:改動一個基因,觀察細胞反應。麻煩在規模。當實驗同時涵蓋大量基因與多種細胞類型,資料表迅速膨脹,而表格只呈現變化,不會自動解釋變化的意義,更不會指出它對應哪個機制或疾病。
解讀的擔子全落在研究者身上。核對分類、查文獻、判斷價值,每一項都要時間;逐一處理的結果是,弱訊號、跨領域線索與意外結果被排到隊伍後面。這是覆蓋率受限於人力的老問題,但它的另一面同樣成立:資料沒被讀完是損失,卻也不代表所有資料都值得追查,更不代表演算法能替研究者下結論。
這也不是 AI 代理第一次被用來搜尋生物研究線索,先前的抗菌勝肽案例走過類似的路。這次的重點移到基因擾動任務的分派與彙整,同時把一個問題推到更前面:搜尋規模放大之後,篩選與驗證的位置在哪裡。
數千個代理,各自認領一項擾動
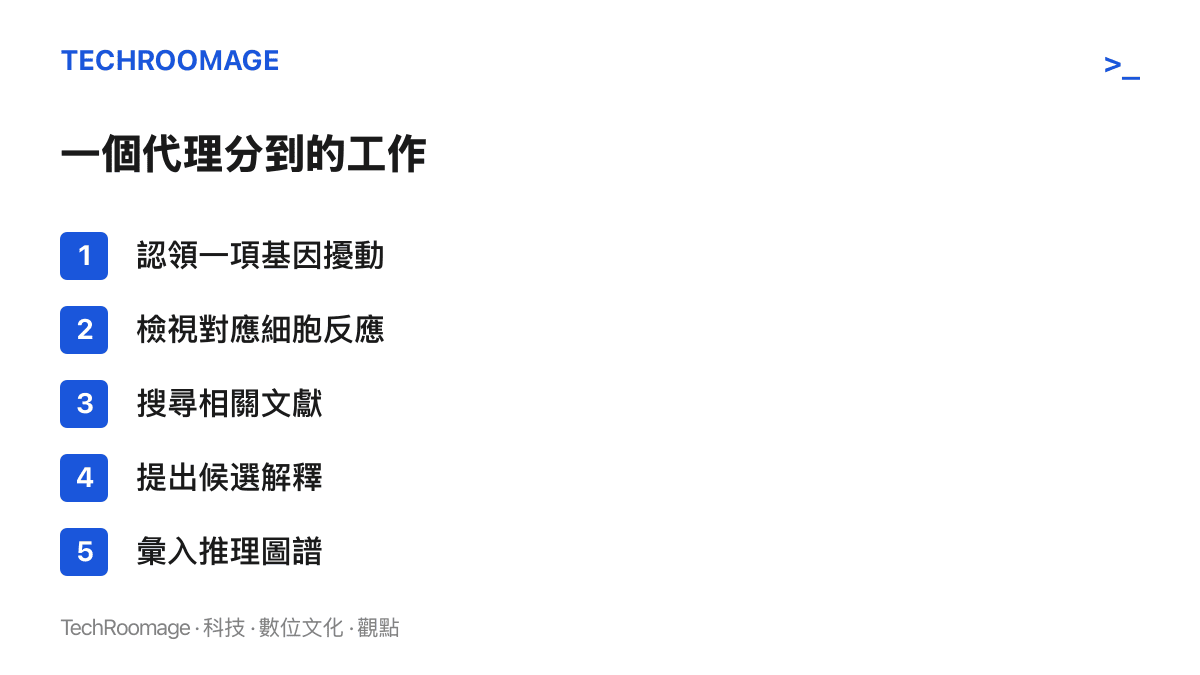
這套分散式生物推理的做法,核心是任務切分。大問題先拆成小任務,每個代理認領一項基因擾動,檢視對應的細胞反應,搜尋相關文獻,提出解釋;所有報告最後彙整成推理圖譜(reasoning atlas),把基因、細胞效應、文獻與可能機制連在一起。
平行化的價值在任務邊界。單一代理一次拿到整份大型資料,得在有限的時間與上下文裡取捨;切成小任務後,更多項目能同時進入整理流程。代理的產出則應視為帶著來源脈絡的候選解釋:某項基因擾動在特定細胞類別造成變化,文獻裡恰好有一種可比對的機制。至於這條線索對不對、新不新穎、值不值得設計實驗,研究者仍要回到原始資料與文獻確認。
換句話說,代理提高的是被完整整理的項目數量;一條線索值不值得追,仍是研究者回到原始資料後的判斷。
七百篇對十一篇,數字先問分母與條件
OpenAI 的發布資料裡有兩組常被引用的比較。負載最大的測試中,分散式代理引用超過七百篇文獻,單一代理引用十一篇;盲測中,專家有 75% 的比例偏好分散式代理的報告。
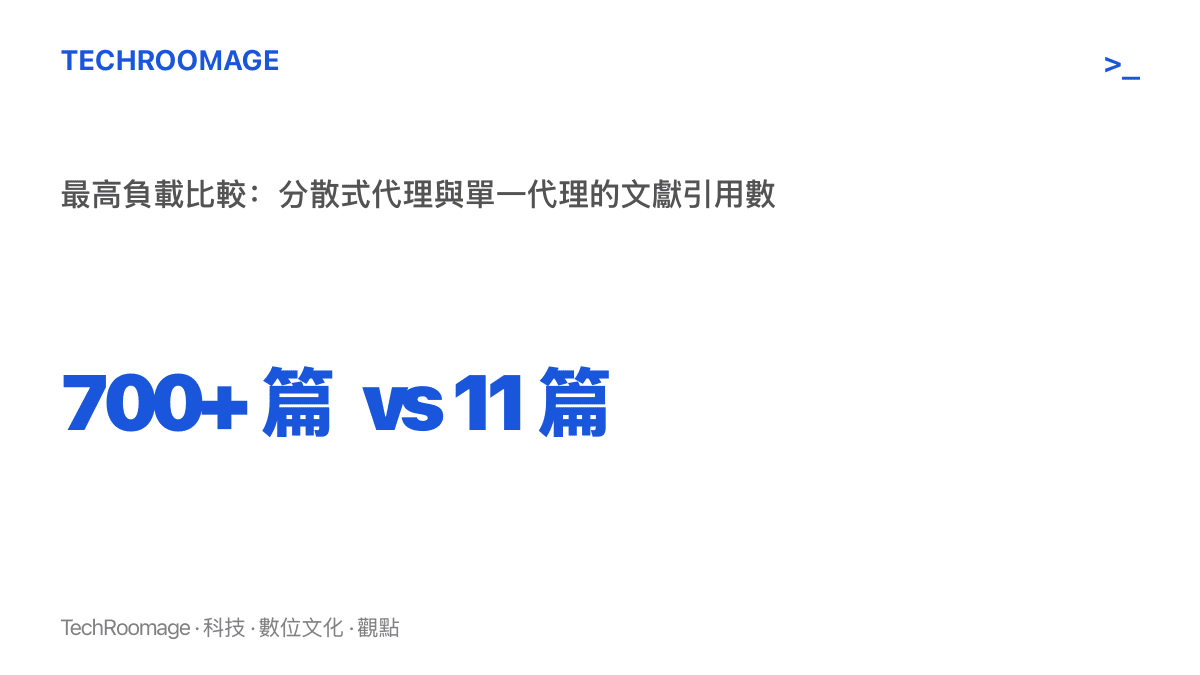
這些都是發布團隊報告的數字,解讀時有層次可分。引用數較多,說明檢索覆蓋較廣,不能證明每條引用都與問題相關。專家偏好說明報告讀起來較有說服力,但偏好與假說正確、實驗重現之間,各隔著一段距離。要評斷效能,得回到原始評估設計:評分標準怎麼定、樣本數多少、可重複的分析產物有沒有釋出。這與我們先前整理OpenAI 在 COBOL 遷移評測的數字口徑時的原則相同:先問分母與條件,再談結論。
三十二分鐘對數月到一年的對比也屬同一類。那是研究團隊的估算,換一個實驗室、另一份資料集、另一個研究問題,效能不會自動複製。更有用的問法是:這套流程覆蓋了哪些結果、漏掉哪些結果,多出來的線索有沒有實際減少後續的搜尋工作。
複核與驗證,守的是兩道不同的門
人工複核檢查推理與文獻。代理有沒有正確描述資料、引用是否支持它的說法、排序理由是否清楚,都在複核範圍內。實務上有幾種常見陷阱:題名相近的論文探討的可能是不同的問題;相關的變化可能被寫成因果。研究者需要回查原始圖表、方法與被引用的段落,而這件事有個前提:輸出必須標明資料與文獻來源,否則複核無從下手。
實驗驗證檢查的則是生物本身。把假說轉成可否證的問題,定義量測方式與對照條件,看候選機制能不能在設計好的實驗裡重現。專家在盲測裡覺得一份報告值得追查,與機制被證實,中間隔著完整的實驗設計與執行。
兩道關卡容易在新聞敘事裡被壓縮成一句「專家看過了」,實際上各守一邊:複核把關推理品質,驗證把關生物事實。導入代理流程的團隊若只安排了前者,所有線索都會停在讀起來合理的階段。
導入之前,先回答四個問題
第一個問題是任務要切多細。任務太粗,代理只做得出摘要級的整理;太細,重複與相互矛盾的報告會墊高彙整成本。切分方式要按實際任務評估,沒有一體適用的答案。
第二個問題是資料治理。資料怎麼切分、代理能讀取哪些範圍、輸出附帶什麼證據、誰有權決定後續實驗,這些屬於流程設計階段就該定下的規則。代理可讀取的資料範圍,同時決定了洩漏與誤用的風險面。
第三個問題是成本歸屬。數千個代理跑三十二分鐘,運算開支與單一代理不在同一個量級;這類批次分析該記在誰的預算、怎麼分攤,導入前要有答案。我們先前在企業 AI 用量的費用歸屬一文整理過同樣的課題:設上限之前,先回答費用記在誰的帳上。
第四個問題是重現條件。同一份資料、同一套流程,換一個模型版本或一組提示詞,圖譜會不會長得不一樣?沒有版本控制與固定的分析產物,團隊之間無法互相比較結果,事後也難以稽核。
接下來可以依序核對的訊號
短期看兩件事:有沒有獨立團隊用自己的資料集重跑這套流程並公開結果;這次推理圖譜裡的任何一條線索,有沒有真的進入實驗驗證並發表。中期再看兩件事:評估設計的細節,包括評分標準與樣本數,有沒有隨分析產物一起釋出;代理流程會不會從重讀既有資料,走向協助規劃新實驗。
在這些訊號出現之前,比較穩的定位是把這套方法當成搜尋與整理的擴音器。線索的生產成本下降之後,驗證能力會變成新的瓶頸;評估要不要導入的團隊,值得把這個比例一起算進去。
資料來源:本站編輯參考 APPI News〈AI代理如何搜尋生物資料?候選線索仍須實驗驗證〉(作者:張饒輝 Lightman Chang)改寫而成,原文出處;原文文字內容採 CC BY 4.0 授權。